RMSNorm:归一化只需要缩放,不需要中心化
2023 年之后发布的开源模型——Llama、Qwen、DeepSeek、Gemma——在归一化层上做出了同一个选择:RMSNorm。它不是更好的 LayerNorm,而是更小的 LayerNorm:删掉均值、删掉偏置,剩下的部分就足够了。
这篇文章回答三个问题:删掉的到底是什么、为什么敢删、以及两行代码怎么把它写出来。
前置知识:公式里的每个符号
后面两个公式一共出现五个希腊字母,先一次说清——每一个都不复杂,复杂的是它们组合出来的效果。
| 符号 | 读作 | 是什么 | 怎么来的 |
|---|---|---|---|
| 缪 (mu) | 均值(mean) | ,向量所有元素的平均数 | |
| 西格玛平方 (sigma) | 方差(variance) | ,每个元素离均值有多远,再取平均 | |
| 伊普西龙 (epsilon) | 一个极小的数,如 1e-5 | 直接写死的常数,防止除以 0 | |
| 伽马 (gamma) | 可学习的缩放参数 | 神经网络训练时自己学出来的,初始值全是 1 | |
| 贝塔 (beta) | 可学习的偏移参数 | 也是学出来的,初始值全是 0 |
记忆方式: 和 是统计量(从数据算出来), 和 是参数(训练学出来), 是工程保底(写死的)。RMSNorm 删掉的全部内容,就是这张表里的一半。
删掉的到底是什么
原始 Transformer 用 LayerNorm 处理深层网络的激活漂移:
RMSNorm 把它砍成:
被删除的三个组件:(一次全量归约)、(依赖 的第二次归约)、(一份参数加一次加法)。保留的 RMS 不做中心化,直接对平方取均值再开方。
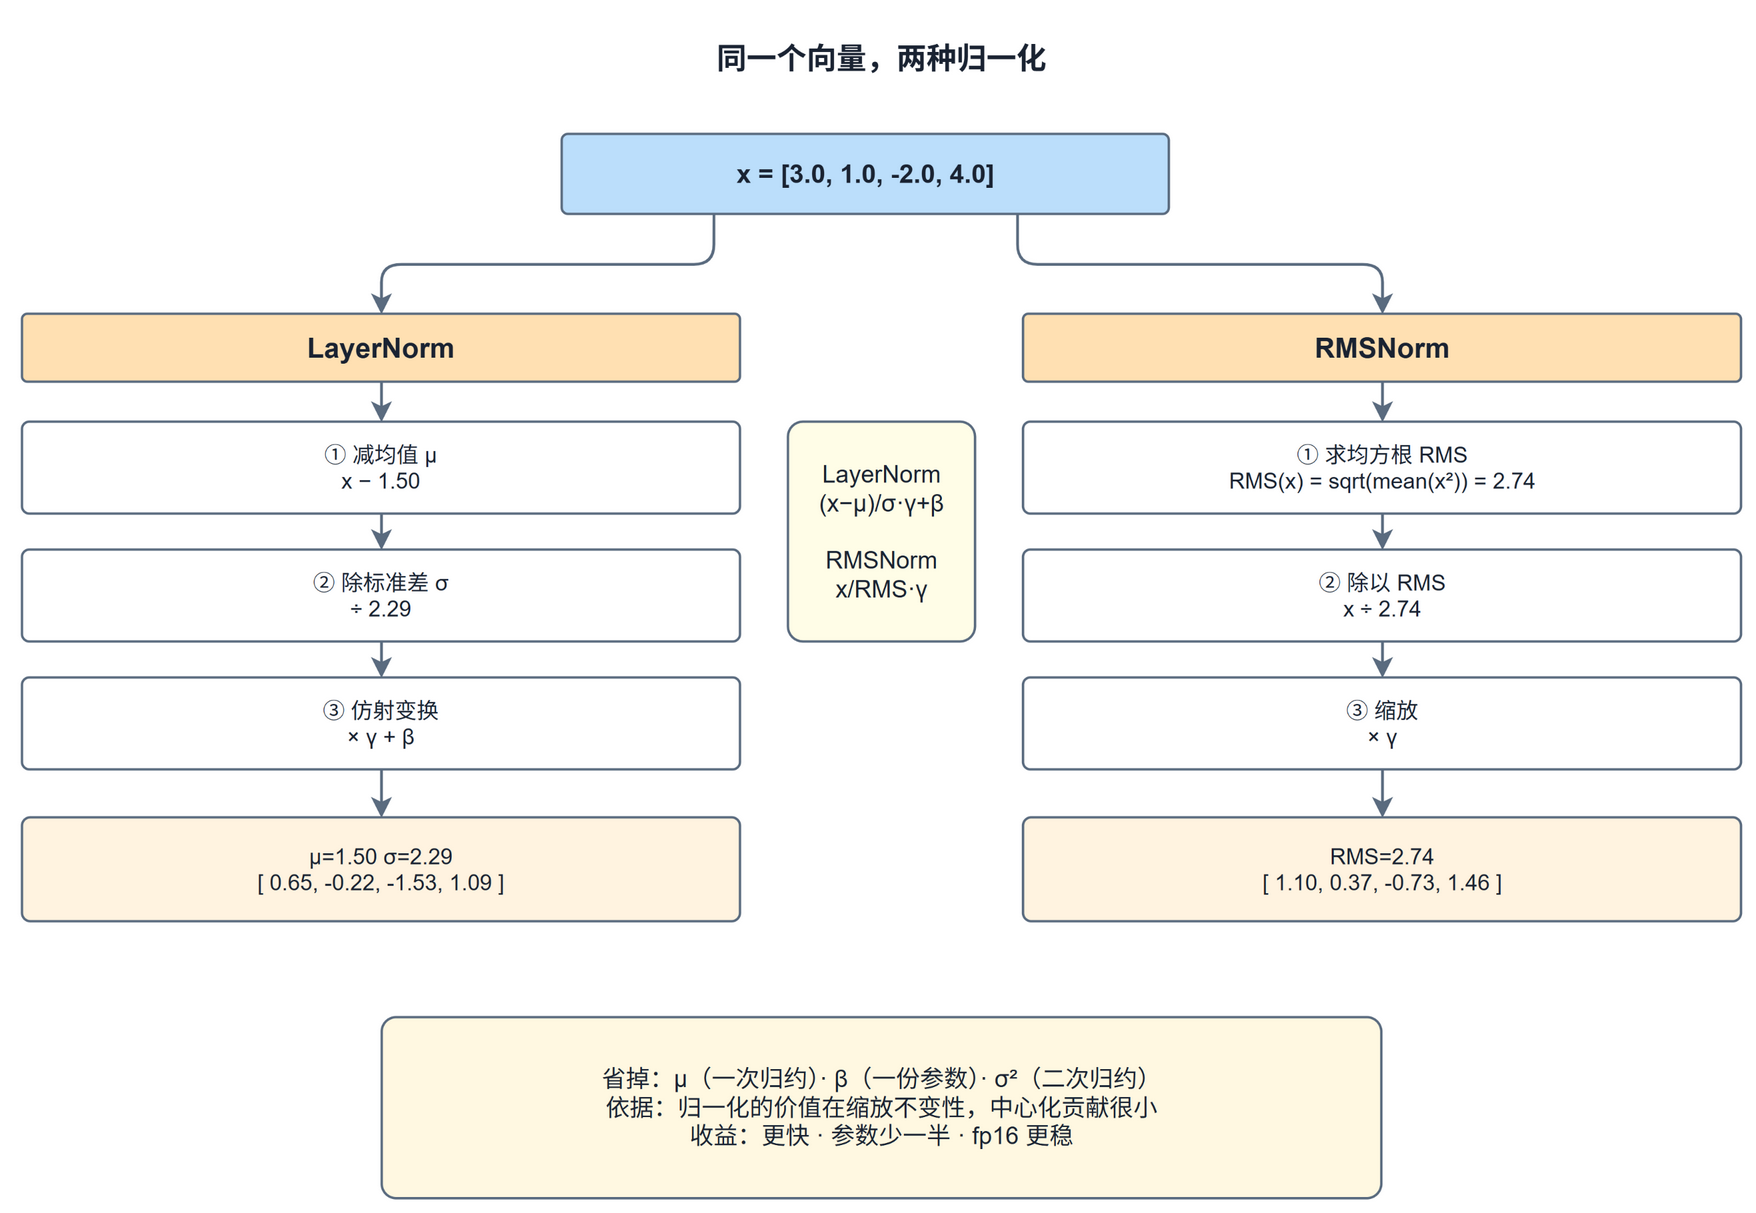
用一个四维向量手算一遍,差异比公式更直观。:
LayerNorm:  μ=1.50  σ=2.29  →  [ 0.65, -0.22, -1.53,  1.09]
RMSNorm:    RMS=2.74         →  [ 1.10,  0.37, -0.73,  1.46]
两个输出的区别在分布形状:LayerNorm 强制零均值(正负各半),RMSNorm 只管缩放、不管中心(整体偏正)。这个差异就是被删掉的中心化——问题在于,它重要吗?
为什么敢删
RMSNorm 论文(Zhang & Sennrich, 2019)的核心贡献不是这个层本身,而是一个消融结论:把 LayerNorm 的 re-centering( 和 部分)整个移除,各项任务的性能基本不动。
这个结果指向对归一化机制的重新理解:归一化的有效性几乎全部来自缩放不变性,中心化是可以免费丢弃的部分。 深层网络的真正问题是激活方差逐层漂移——把每层输入拉回稳定尺度,梯度就稳了。至于输出的中心是不是零,模型并不在乎。
删除后的收益可以列得很具体:
- 少一次完整的数据依赖归约( 依赖 ,删 连带删两次归约);
- 参数量减半(只有 );
- fp16/bf16 训练下数值路径更短,更稳。
「效果不掉 + 更快 + 更简单」三者同向,这种机会在深度学习里不多。所以 2023 年后的模型几乎清一色切换,这不是巧合,是证据驱动的一致选择。
两行实现
公式到代码几乎是直译:
import torch
import torch.nn as nn

class RMSNorm(nn.Module):
    def __init__(self, dim: int, eps: float = 1e-5):
        super().__init__()
        self.eps = eps
        self.weight = nn.Parameter(torch.ones(dim))   # γ,初始全 1

    def forward(self, x):                             # x: (B, S, d)
        return x * torch.rsqrt(
            x.pow(2).mean(-1, keepdim=True) + self.eps
        ) * self.weight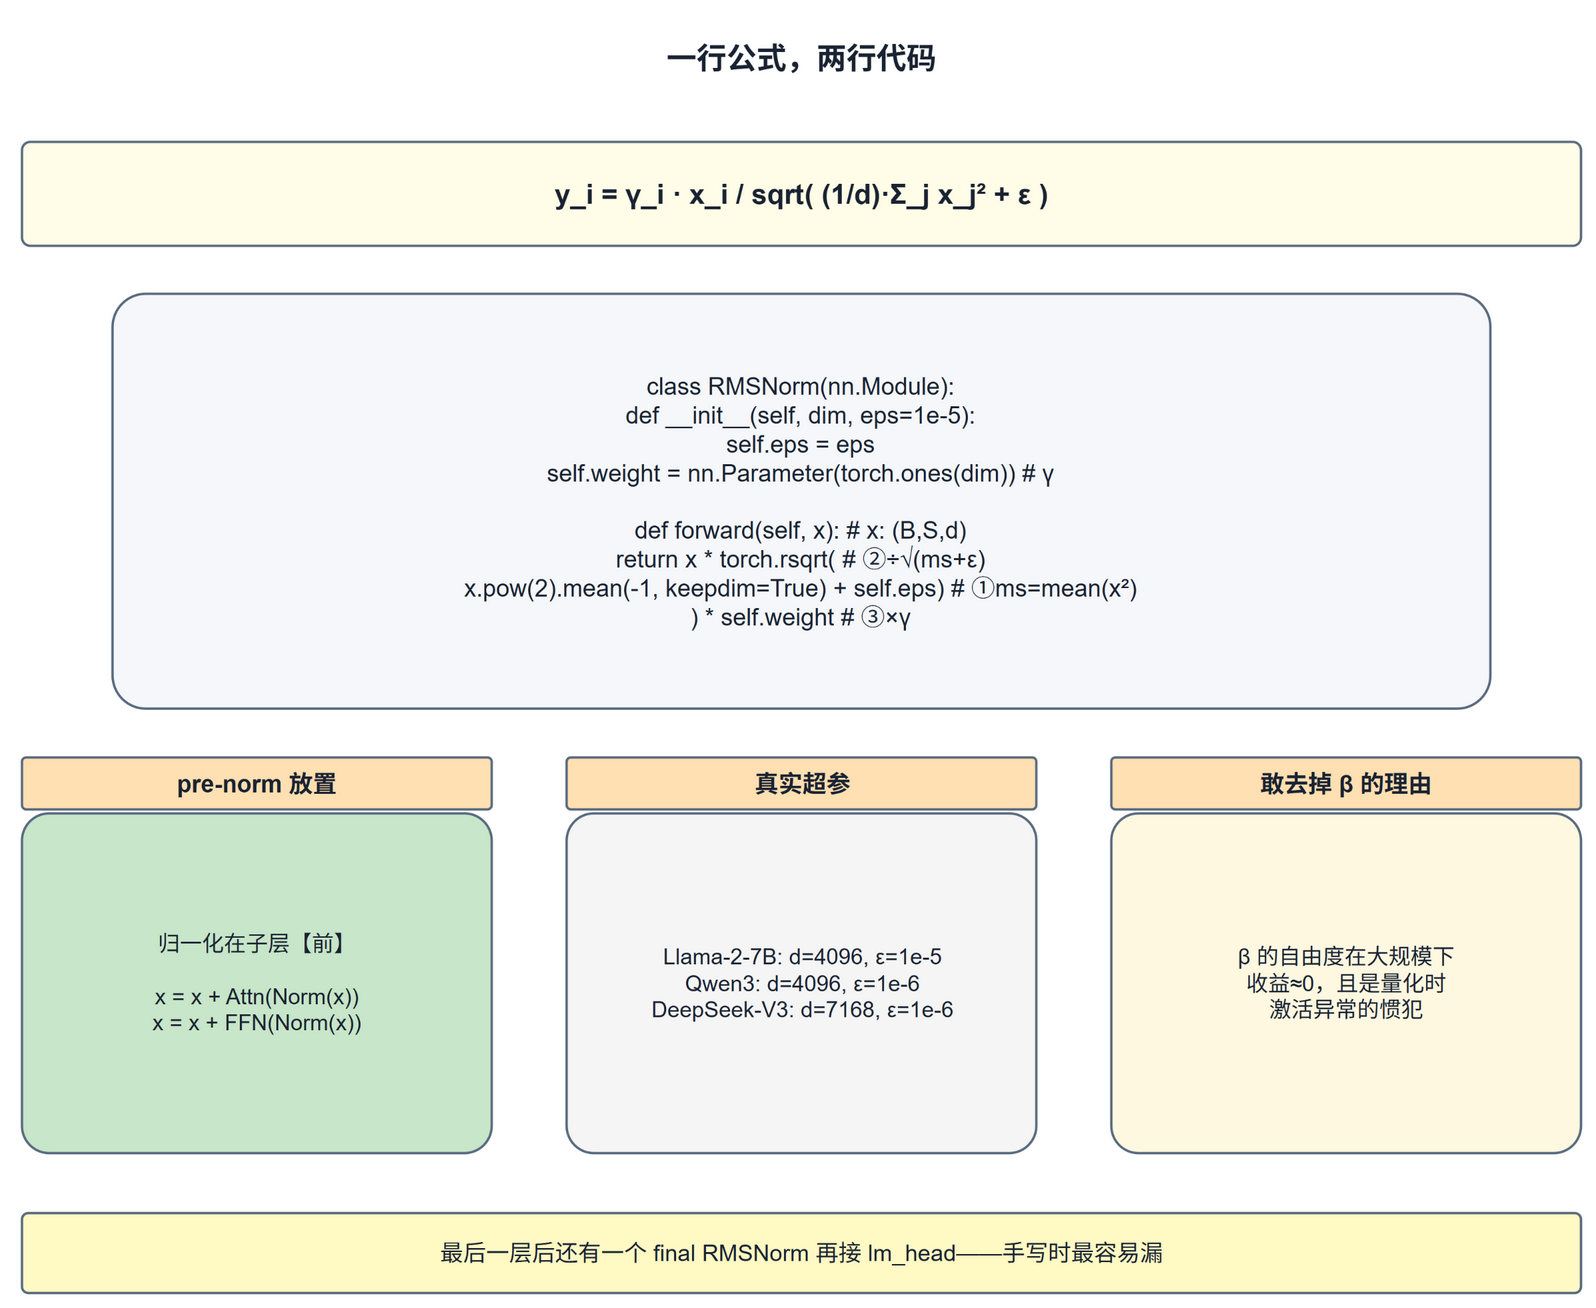
三个实现细节决定了这段代码的正确性:
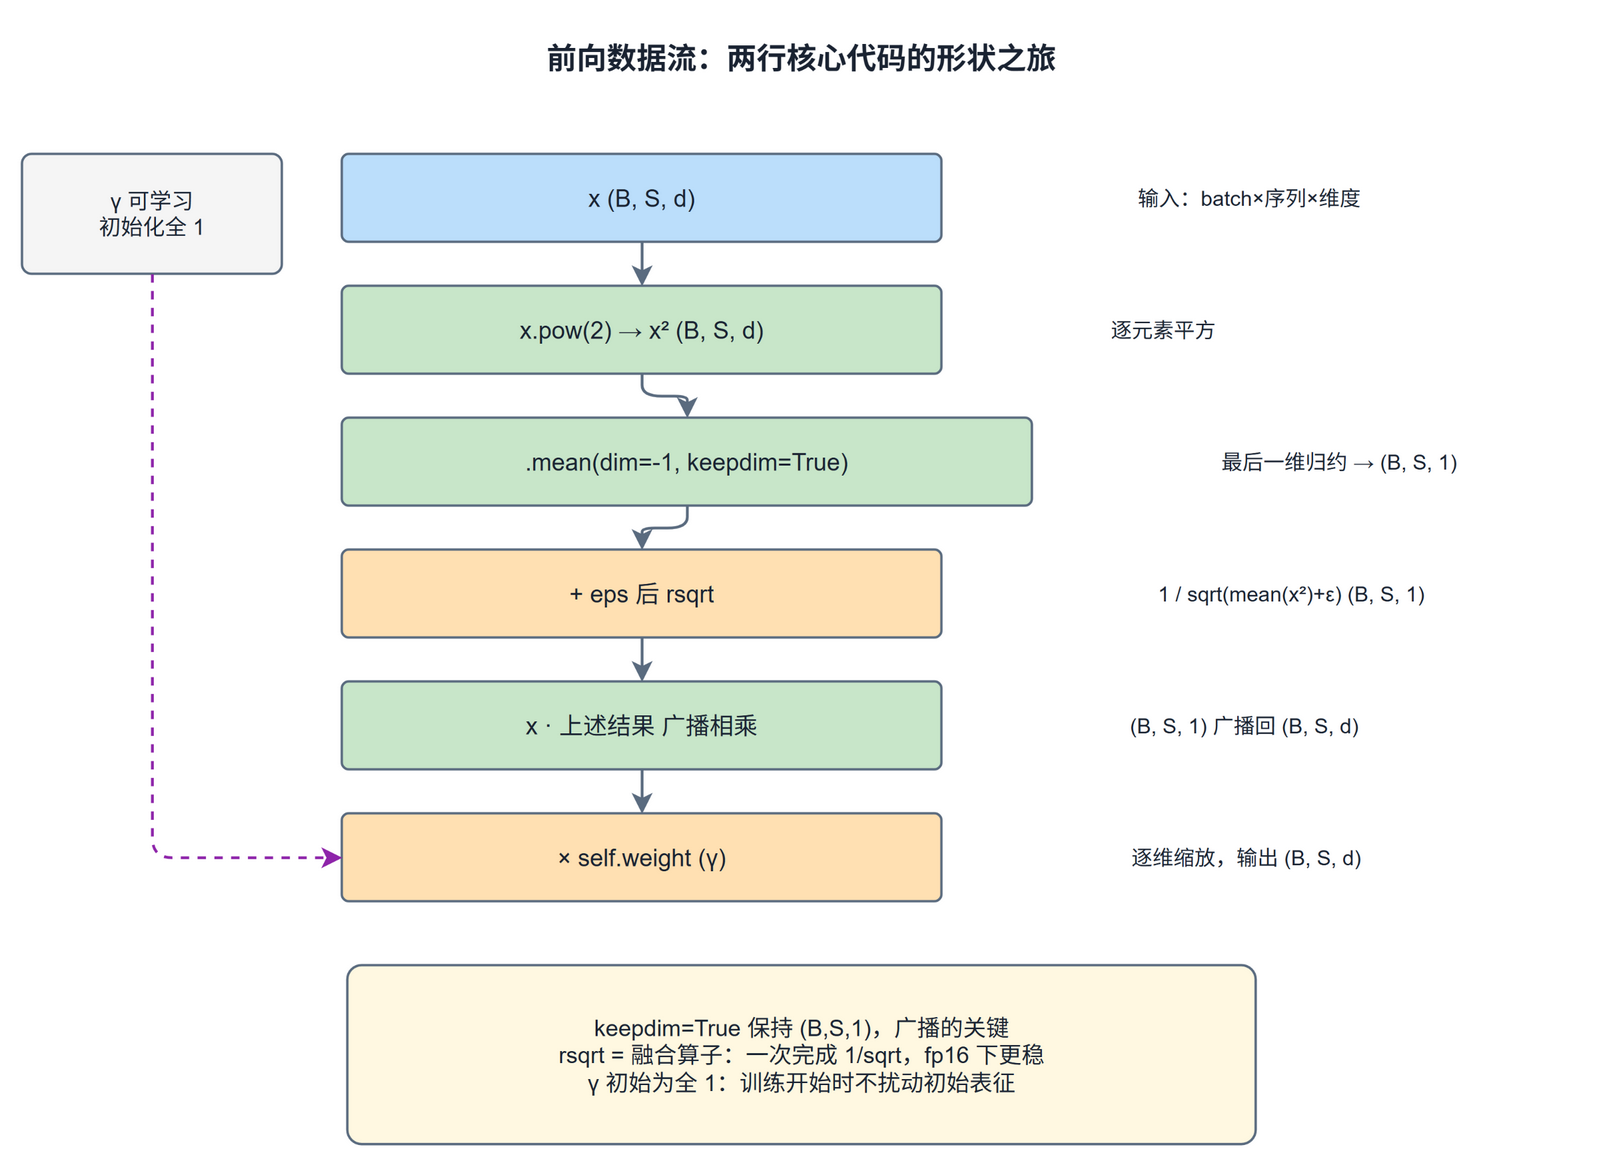
keepdim=True 是广播的关键。 的形状是 ,在最后一维归约后得到 而不是 ——后者无法广播回原形状。keepdim 保留的那个长度为 1 的维度,让每个 token 用自己的 RMS 归一化自己,一行完成。
rsqrt 不是一个写法偏好。 它是融合算子,一次 kernel 完成 和取倒数;分开写 1/torch.sqrt(...) 是两次 kernel、两次潜在精度损失。fp16 下这个差别真实存在。
γ 初始化为全 1 意味着训练开始时 RMSNorm 的输出就是干净的归一化结果,没有任何初始扰动——这是它训练稳定性的一个组成部分。
前向计算中张量形状的完整流转:
验证三个性质
代码写完不算完,跑一遍确认它真的具备(和不具备)哪些性质:
torch.manual_seed(0)
x = torch.randn(2, 16, 256) * 3 + 1     # 故意构造非零均值

norm = RMSNorm(256)

# ① 缩放不变性:输入整体乘 k,输出不变
torch.allclose(norm(x), norm(x * 7), atol=1e-5)   # True

# ② 输出 RMS 被锁定在 γ(初始 γ=1)
norm(x).pow(2).mean(-1).sqrt().mean()             # ≈ 1.0

# ③ 平移敏感:整体加常数,输出会变
torch.allclose(norm(x), norm(x + 5), atol=1e-5)   # False
① 是归一化的本职:无论输入尺度怎样漂移,输出不变——这就是「缩放不变性」的直接体现,也是深层网络训练稳定的来源。② 说明输出尺度被严格锁定,激活不会逐层膨胀。③ 是它没有解决的问题:中心化被删掉了,平移会穿透到输出。实践里这不是问题——残差流里「所有维度同加一个常数」的扰动模式很少见,后续层和 会把它吸收掉。
pre-norm:位置和层本身一样重要
RMSNorm 生效有一个前提:放在正确的位置。Llama 系列全部采用 pre-norm——归一化放在子层之前,残差从外面绕过:
x = x + attn(rmsnorm(x))    # 先归一化,再进注意力,输出加回残差流
x = x + ffn(rmsnorm(x))
对比原始 Transformer 的 post-norm(norm(x + sublayer(x))):pre-norm 的残差通路是干净的,梯度沿加法分支直通底层,不穿过任何归一化的摩擦。几十层的模型能稳定训练,这一行顺序的贡献不小于归一化本身。
代价是残差流的尺度没有被管理,所以 Llama 在最后一个解码层之后补了一个 final RMSNorm 再接 lm_head——手写实现时最容易漏的就是这个结尾。
顺带一提,Llama 全面去掉 Linear 层的 bias 也是同一个思想:RMSNorm 的 是乘性缩放,已经覆盖了「调整每维幅度」的需求; 这样的加性自由度在大规模下收益趋近于零,还会在长训练里单调漂移、干扰 INT8/FP8 量化。乘性缩放优于加性偏置——Qwen3 删掉 QKV-bias 换 QK-Norm,是同一判断的第二次出现。
总结
- RMSNorm = LayerNorm − 中心化:不减均值、不除标准差,只除 RMS、只乘 γ;
- 敢删的依据是消融实验:归一化的价值在缩放不变性,re-centering 是可丢弃的装饰;
- 两行核心代码,三个细节:keepdim 广播、rsqrt 融合、γ 初始化全 1;
- pre-norm + final norm 才是完整用法;
- 未解决的:平移会穿透输出——实践中无关紧要,但值得知道。
延伸
两个顺藤摸瓜的方向:把 RMSNorm 换回 LayerNorm 训一个小模型,看训练曲线到底差多少(消融结论的自己复现版);以及 FlashRMSNorm 这类 fused kernel 在这两行代码之上还优化了什么(归约与缩放的融合,省一次显存读写)。