从 ReLU 到 SwiGLU:FFN 的门是怎么装上的
先说结论:SwiGLU 不是一个激活函数,是一个结构改动。你在 model config 里看到的那行 hidden_act: "silu",只是冰山露出来的那一小块——真正的变化是 FFN 从 2 个矩阵变成了 3 个。
下面按「是什么 → 为什么 → 划算吗」的顺序讲,看完你应该能对着 Llama 的代码点头。
一、先看原来的 FFN 长啥样
2017 年 Transformer 原版的前馈层,简单到离谱:
升维(4096→16384)→ 过个 ReLU → 降维回来(16384→4096),就这。两层线性夹一个激活函数。每个 token 各过各的、互不串门,所以叫 position-wise:注意力层管 token 之间怎么交流,FFN 管每个 token 自己内部怎么加工。前者是开会,后者是回工位干活。
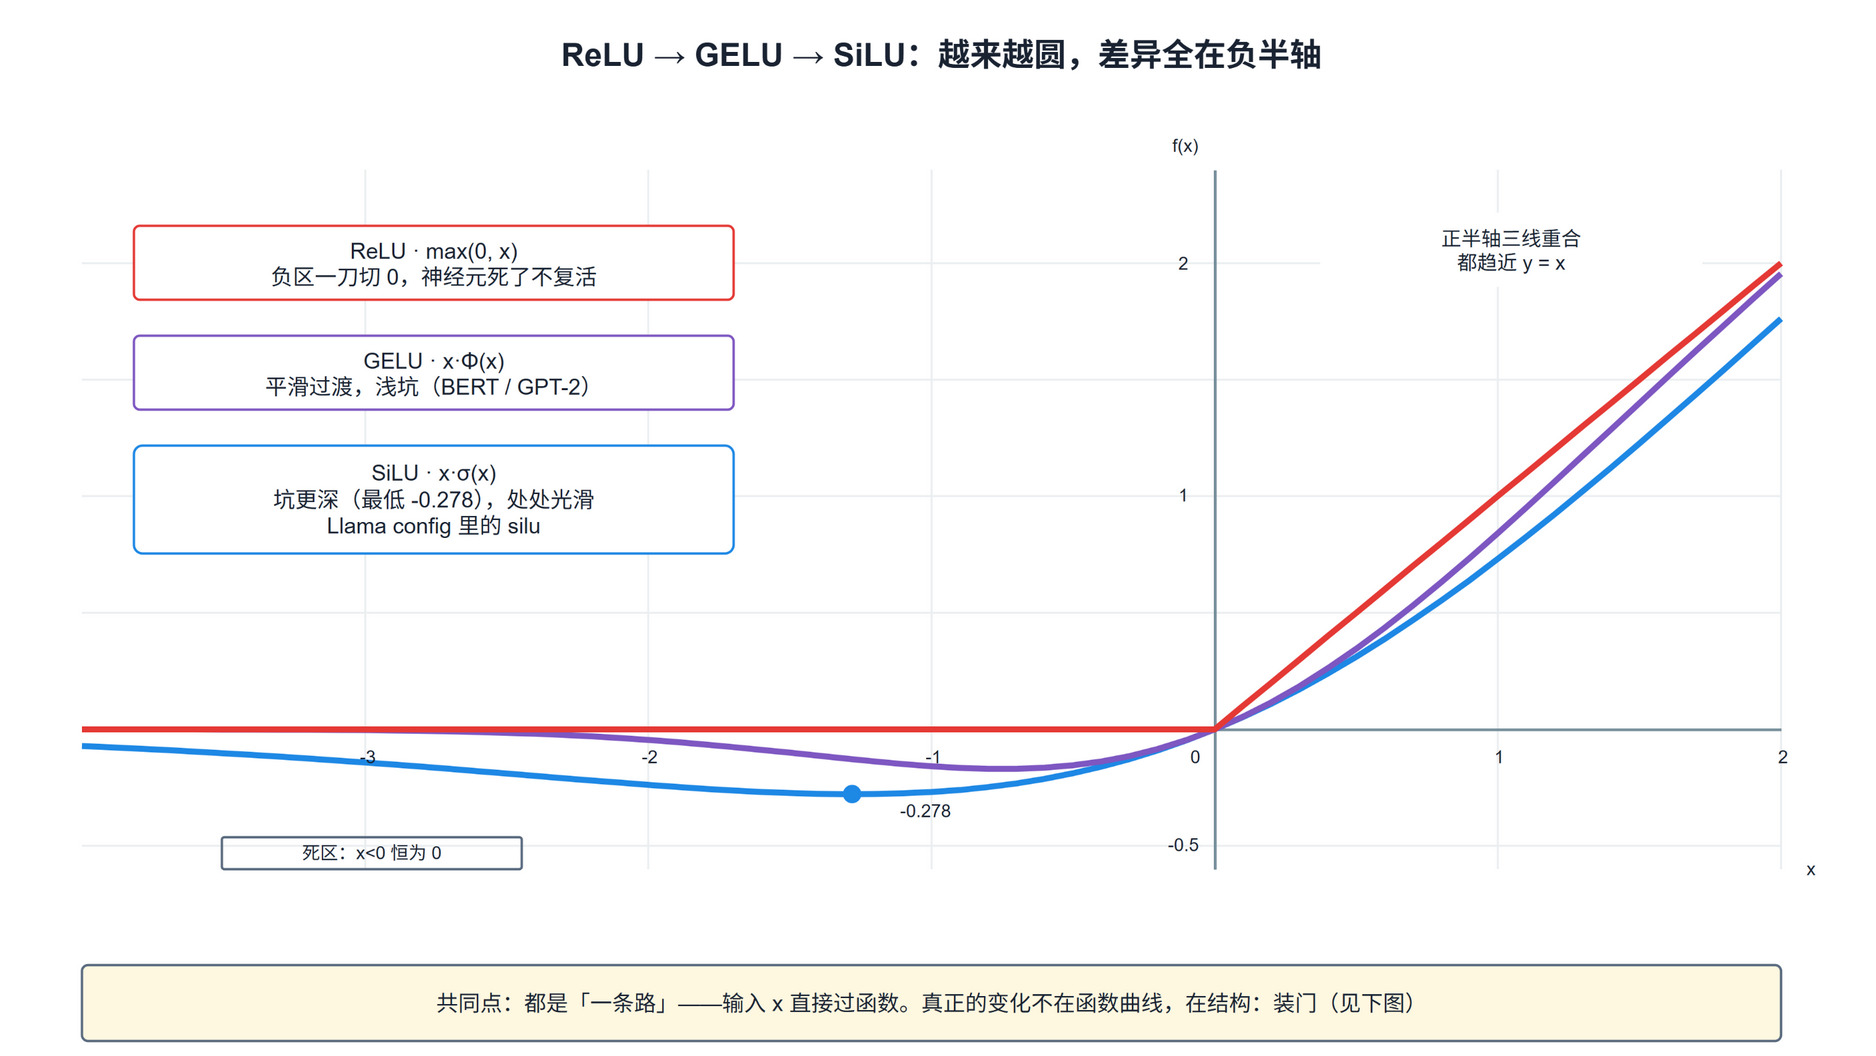
ReLU 有个老毛病: 把负数一刀切成 0。切得太狠,有些神经元从此再也没有输出——江湖人称「死神经元」,死了不复活(梯度恒为 0,权重不再更新)。
二、第一步:把 ReLU 磨圆(SiLU)
后来的故事大家熟:GELU(BERT/GPT-2 用的)、SiLU(=Swish,Google 用搜索搜出来的函数)。
曲线画出来和 ReLU 挺像,但有两个细节不同:
- 负数不是全砍成 0,留了个小尾巴(最低点在 ,值 )
- 处处光滑,没有折点
就……没什么玄的,平滑版 ReLU,负区留活口。Llama config 里写的 silu 就是它。
三、第二步:真正的重点来了——装门
只换激活函数,那是小修小补。Shazeer 2020 年(GLU Variants Improve Transformer)干的事才是大动作:给 FFN 装个门。
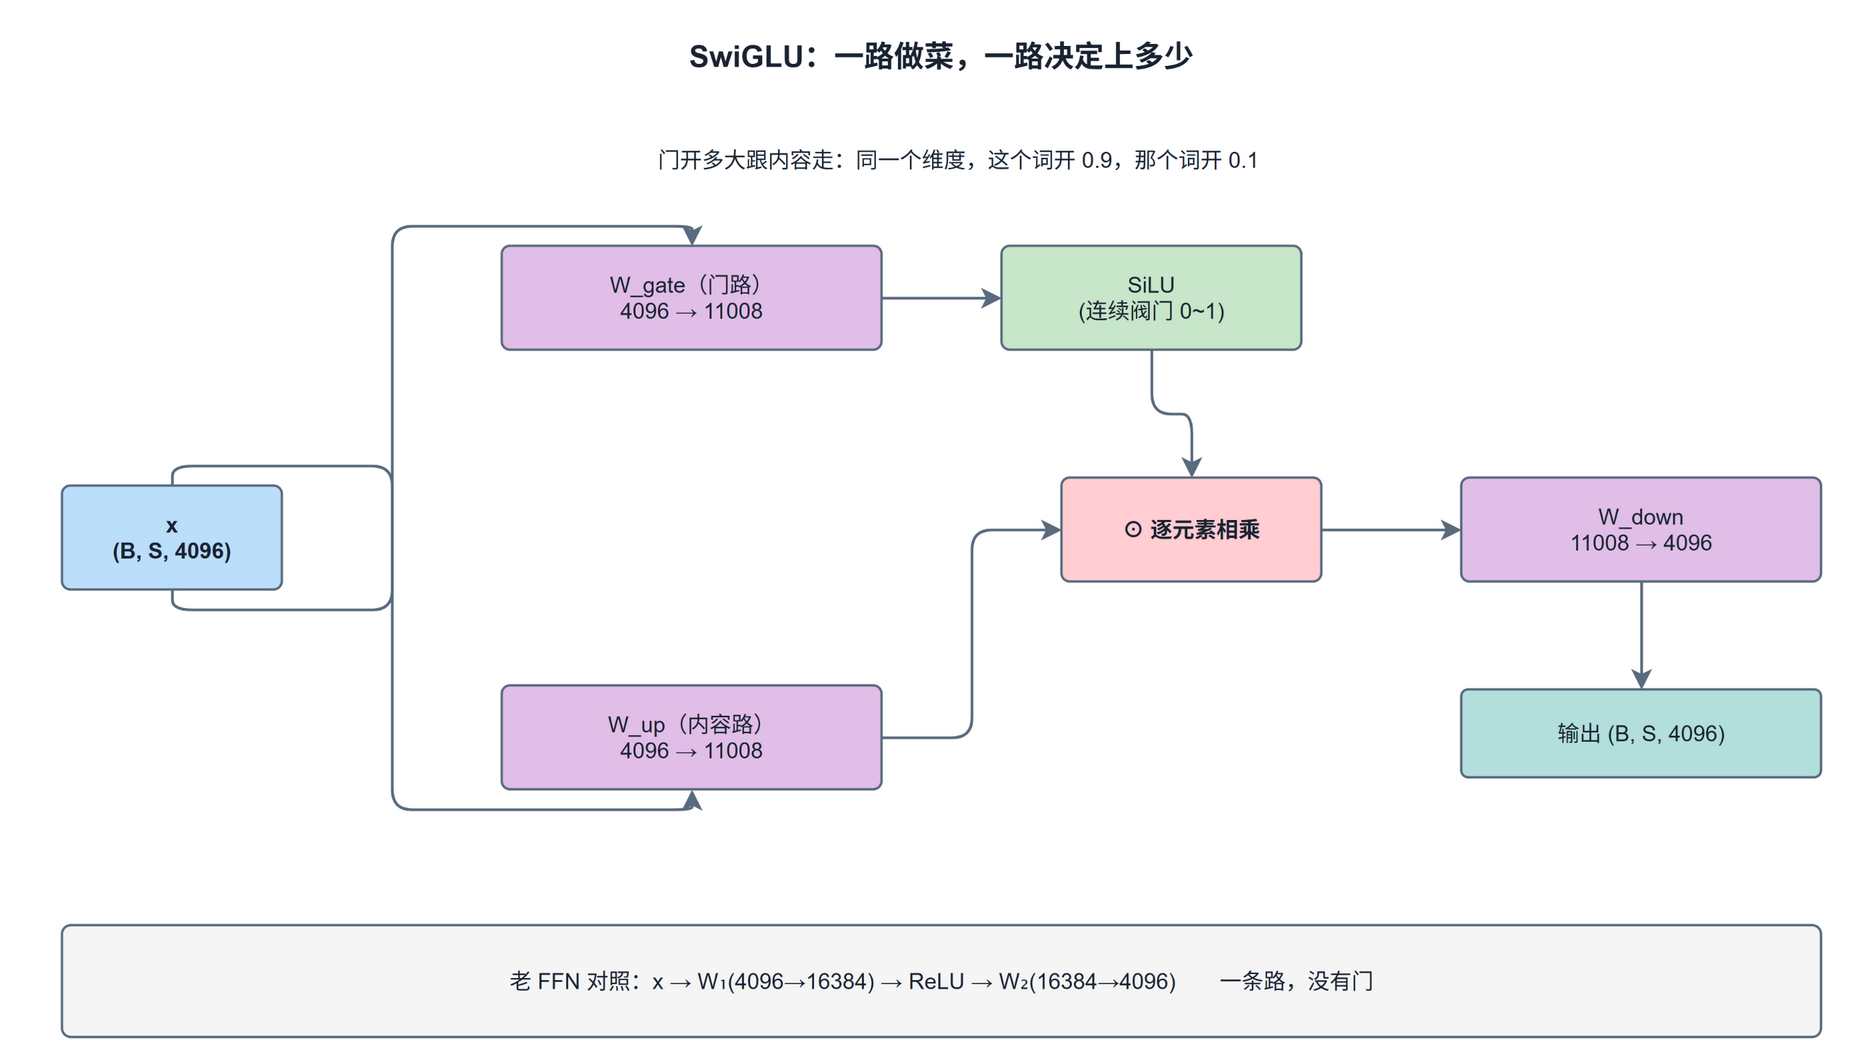
原来一条路:
现在两条路:
- 内容路 ——正经做菜
- 门路 ——决定每道菜上多少
然后逐元素相乘(),再过 降维。
注意一个细节:这个门不是 0/1 开关,是连续的阀门,而且开多大是跟着每个 token 的内容变的——同一个维度,这个词来了开 0.9,那个词来了开 0.1。菜还是那道菜,上多少看情况。
说白了:以前 FFN 对所有输入一视同仁地过激活函数,现在它会看菜下饭了。
门里塞什么激活函数其实是个全家桶选项:sigmoid、ReLU、GELU、Swish 都试过,分别叫 GLU、ReGLU、GEGLU、SwiGLU:
| 门函数 | 名字 | 一句话 |
|---|---|---|
| GLU | 2017 原版门,LSTM 血统 | |
| ReLU | ReGLU | 门也带死区 |
| GELU | GEGLU | 平滑门 |
| Swish | SwiGLU | 论文测出来最好的那个 |
论文测下来 GEGLU 和 SwiGLU 最好,SwiGLU 略胜,大家就用它。后来的复现发现哥几个差距小得可怜——真正值钱的是「装门」这个动作,不是门里塞的哪个函数。
顺带一提,Shazeer 在论文里对「为什么有效」的官方解释是:
We offer no explanation as to why these architectures seem to work; we attribute their success, as all else, to divine benevolence. (我们无法解释这些结构为什么有效;和其它一切一样,归功于神的恩典。)
作者都这么坦诚了,各路博客的「深度解读」你就看着办。
四、灵魂拷问:多一个矩阵,参数不就爆了?
对,这正是最常被忽略的一步。
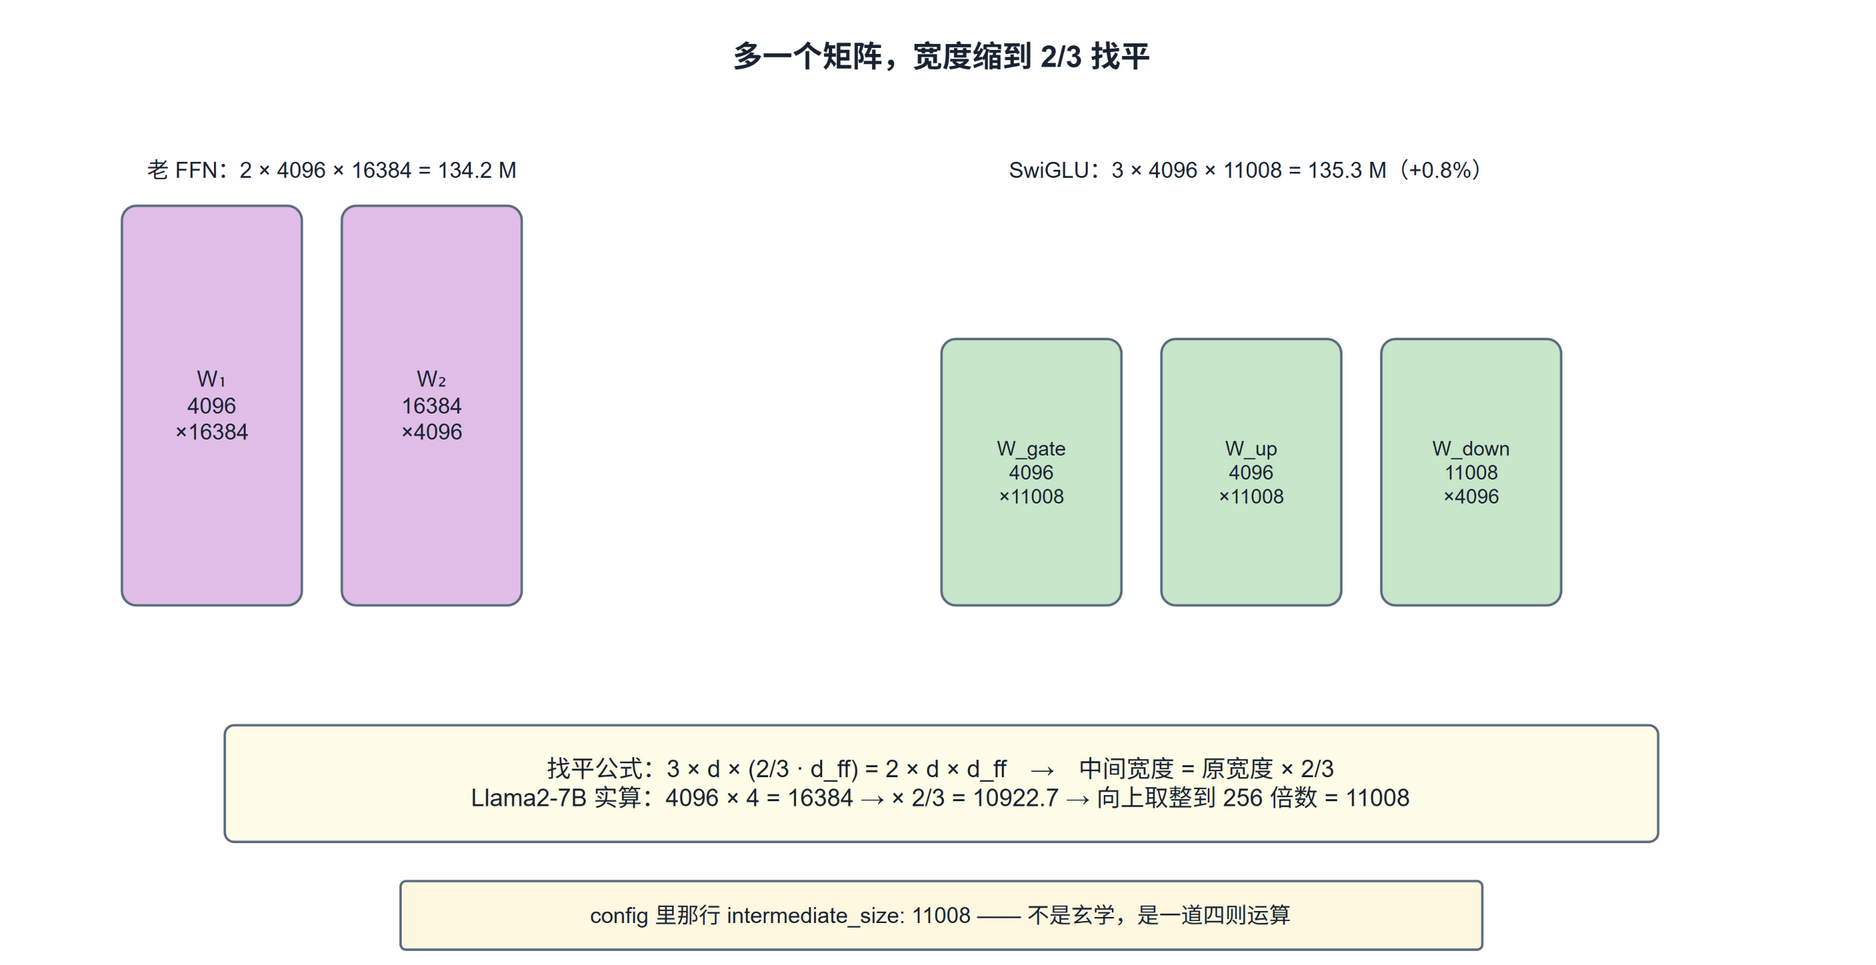
老 FFN 两个矩阵,参数 ;SwiGLU 三个,参数 。同样宽度下多 50%。这买卖怎么平?
答案朴素得可爱:把中间层缩窄到 2/3:
,账就平了。
拿 Llama2-7B 真算一遍:
4096 × 4 = 16384        ← 原来的中间宽度(4 倍扩张)
16384 × 2/3 = 10922.7   ← 缩到 2/3
向上取整到 256 的倍数 = 11008
参数核对:老结构 ,SwiGLU ,差 0.8%——基本打平,取整造成的。
你在 Llama config 里看到的 intermediate_size: 11008,就是这么凑出来的。以后再看到这个数,它不是玄学,是一道四则运算。
五、手算一遍(小数字)
,,权重全用能手算的数:
① 内容路:
② 门路:,过 SiLU(,):
③ 相乘:
④ 降维: 是单位阵,输出就是 。
同一组数字过代码:
import torch
import torch.nn.functional as F

x = torch.tensor([[1., 2.]])
W_gate = torch.tensor([[1., 0.], [0., 1.]])
W_up   = torch.tensor([[1., 1.], [1., 2.]])
W_down = torch.tensor([[1., 0.], [0., 1.]])

out = (F.silu(x @ W_gate) * (x @ W_up)) @ W_down
print(out)   # tensor([[2.1932, 8.8080]])  ← 和手算一致
(输出经 PyTorch 实测。)
六、代码:两代 FFN 并排看
先看老的,两矩阵,谁都能看懂:
class FFN_ReLU(nn.Module):
    def __init__(self, dim=4096, hidden=16384):
        super().__init__()
        self.w1 = nn.Linear(dim, hidden, bias=False)      # 升维
        self.w2 = nn.Linear(hidden, dim, bias=False)      # 降维

    def forward(self, x):                                 # x: (B, S, 4096)
        return self.w2(F.relu(self.w1(x)))                # 一条路走到底
再看 SwiGLU,三矩阵:
class FFN_SwiGLU(nn.Module):
    def __init__(self, dim=4096, hidden=11008):           # ← 宽度缩到 2/3
        super().__init__()
        self.gate_proj = nn.Linear(dim, hidden, bias=False)
        self.up_proj   = nn.Linear(dim, hidden, bias=False)
        self.down_proj = nn.Linear(hidden, dim, bias=False)

    def forward(self, x):                                 # x: (B, S, 4096)
        return self.down_proj(
            F.silu(self.gate_proj(x)) * self.up_proj(x)   # 两路相乘
        )
diff 一共三处:w1 拆成 gate_proj + up_proj(2→3 矩阵)、中间夹的 relu 换成 silu(...) * (一条路变两条路)、hidden 从 16384 变 11008(2/3 规则找平)。没了。
公式和代码的对应关系一行看全:
| 公式 | 代码 |
|---|---|
w2(relu(w1(x))) | |
down_proj(silu(gate_proj(x)) * up_proj(x)) |
SwiGLU 的形状流转全程:
| 步骤 | 形状 |
|---|---|
| x | (B, S, 4096) |
| gate_proj(x) → SiLU | (B, S, 11008) |
| up_proj(x) | (B, S, 11008) |
| 相乘 | (B, S, 11008) |
| down_proj | (B, S, 4096) |
唯一值得说的坑:gate 和 up 数学上可以互换(就是一个命名约定,谁过 SiLU 谁叫 gate),但预训练权重不能互换。加载第三方权重时这俩接反了,不会报错,只会静默输出乱码——和 RoPE 配对搞反一个待遇,跑通但不对,最难查的那种 bug。
七、总结
- SwiGLU = FFN 装门:内容路做菜、门路上菜,看菜下饭;
hidden_act: silu只是表象,结构上 2 矩阵 → 3 矩阵才是本体;- 参数账用 2/3 规则找平,Llama 的 11008 = 16384 × 2/3 取整到 256 倍数;
- 值钱的是门控结构,不是 SiLU 本身(Shazeer:归功于神的恩典);
- 代码十行,坑在 gate/up 不能接反。
延伸
两条线可以接着走:一是 ReLU²(,Grok 和 Nemotron-4 在用)——它走的是另一条路:靠高激活稀疏度省推理(90% 稀疏下性能损失 <0.1%),和门控的「表达力」是不同方向的省钱;二是 FFN 即知识库的视角(key-value 记忆模型、超级权重)——为什么动 FFN 会直接影响模型「记住了什么」,这条线能通向模型编辑。想动手的话:把上面十行 FFN 接进你的 mini-Llama,把 silu 换成 relu/gelu 各训一个小模型,同一个 loss 曲线上画三条——「门函数不重要、门控重要」这句话就自己长出来了。
(系列注:搞出 SwiGLU 的 Shazeer 也是 MQA 论文的作者——GQA 那篇的主角。RMSNorm → RoPE → GQA → SwiGLU,至此 Llama 一个 block 里叫得上名的组件,你都已经拆过了。)