从 MHA 到 MQA 到 GQA:KV 头是怎么一步步省下来的
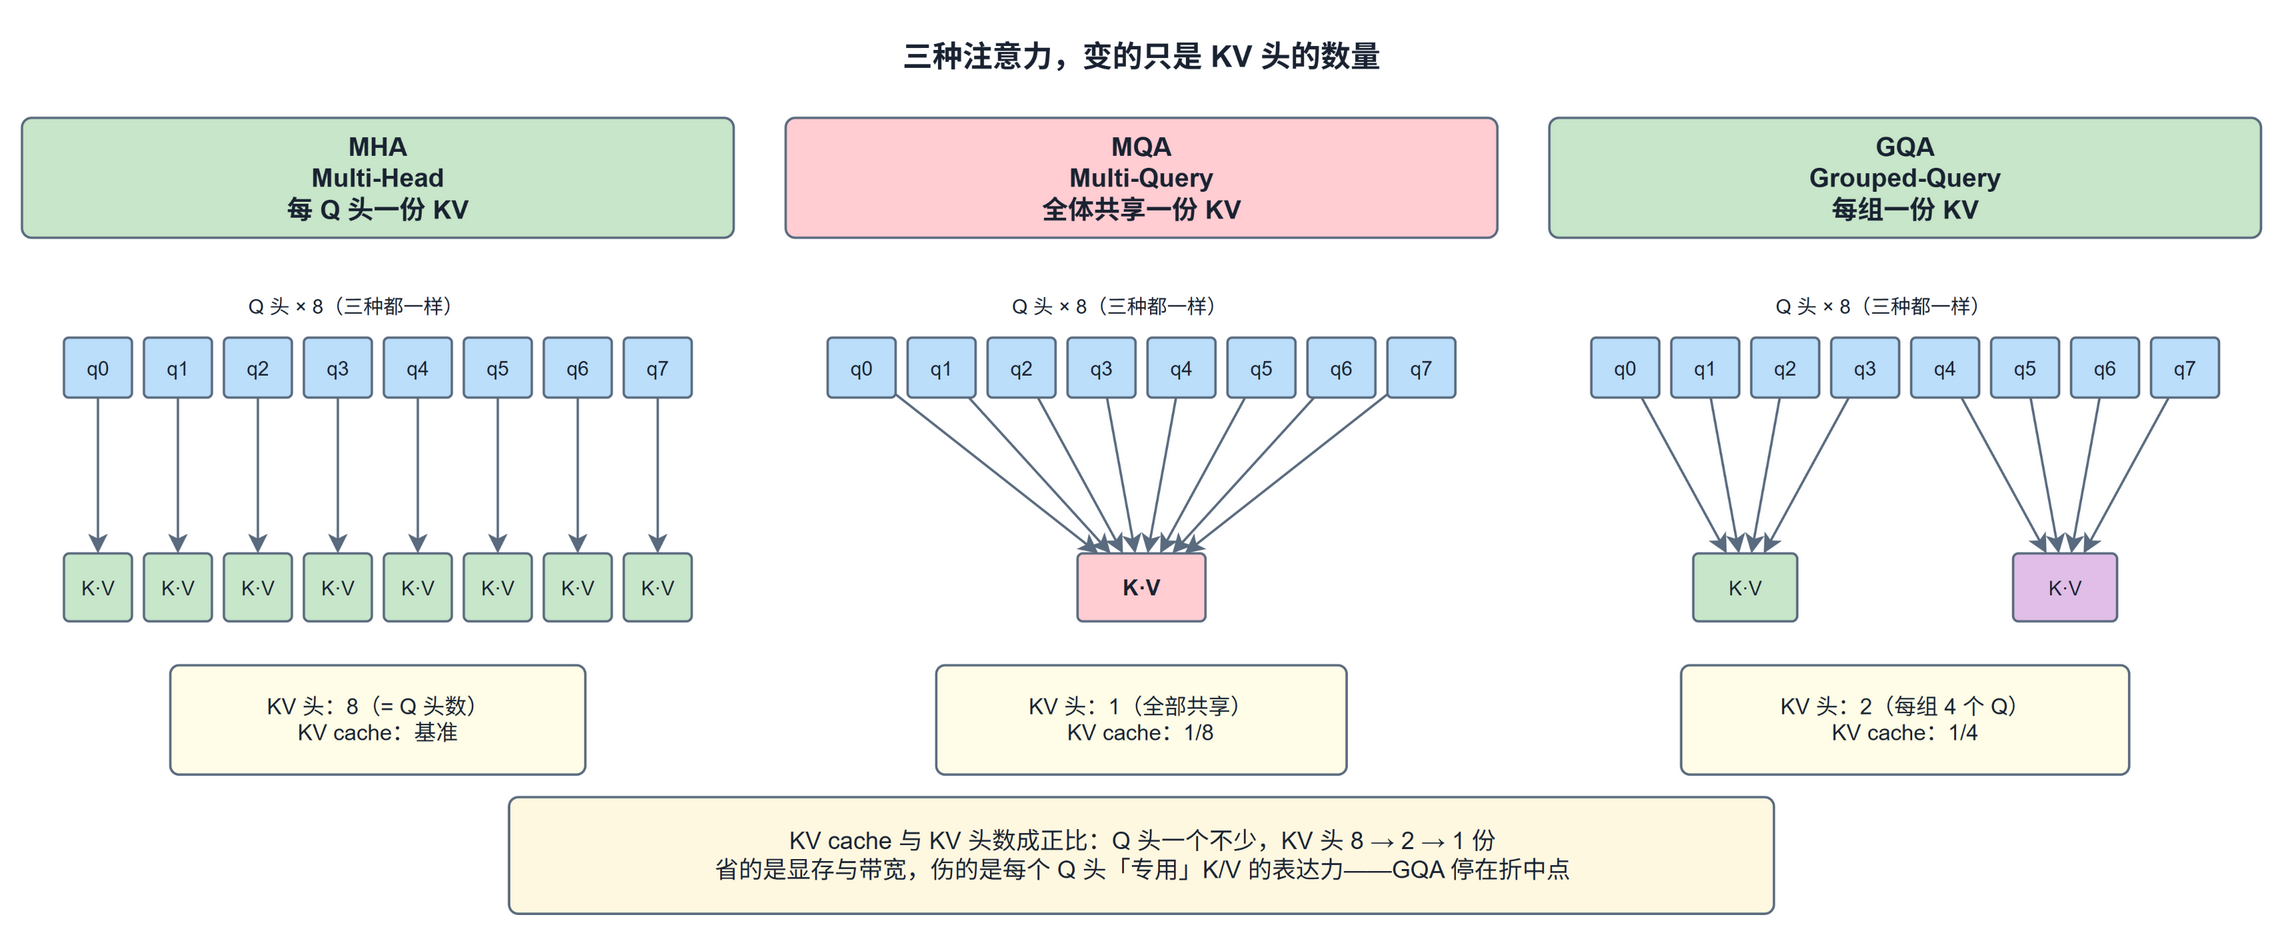
先说结论:三种注意力的区别只在 KV 头的数量上——
| KV 头数量 | 一句话 | |
|---|---|---|
| MHA | = Q 头数(如 32) | 每个 Q 头独享一份 KV,质量最好,KV cache 最大 |
| MQA | = 1 | 所有 Q 头共用一份 KV,KV cache 最省,质量掉得最狠 |
| GQA | 介于两者之间(如 8) | 每 N/Q 头一组共享一份 KV,省得够多,掉得不多 |
Q 头一个没动,动的全是 K、V。为什么 K、V 头数可以不等于 Q 头数?为什么省的是 KV cache?为什么最后停在「按组」?按演进顺序讲:MHA 建立基准,MQA 给出动机,GQA 是终局。
MHA:每个 Q 头独享一份 KV
多头注意力的原始设计(2017):输入 经三个投影矩阵分成 份——
都是 (如 ,即 32 头 × 128 维)。每个 Q 头有自己的 K 头和 V 头:32 个 Q 头,就有 32 份 K、32 份 V,一一配对算注意力,拼起来过 。
训练时这没有任何问题。问题出在推理的 decode 阶段:每生成一个 token,注意力都要回看全部历史 token——所以每个位置的 K、V 算完不能扔,要缓存下来,这就是 KV cache。它多大?
代入 Llama2-7B(32 层,32 KV 头,,fp16):。生成 4096 个 token,单条序列就要 2 GB——模型权重才 13 GB,上下文缓存就吃掉六分之一。batch 越大越吓人:batch 8 就是 16 GB,一张 A100-40G 装不下几条序列,batch 上限被 cache 撑死,吞吐上不去。
更糟的是它不止占显存,还吃带宽:decode 每一步都要把整个 cache 从显存读一遍来算注意力,每 token 生成都要背一遍全部历史的搬运成本。MHA 的问题不在算力,在搬运。
MQA:所有 Q 头共用一份 KV
第一个激进的修正是 MQA(Shazeer, 2019): 的输出宽度从 砍到 ——只有 1 个 KV 头,32 个 Q 头全部读它。
KV cache 直接除以 32:512 KB → 16 KB/token。带宽压力、显存占用同步缩小到 1/32,decode 提速立竿见影。参数也顺带省了: 各从 16.8M 缩到 0.5M。
代价在质量:32 个 Q 头被迫看同一副 K/V 表征,每个头失去自己的「视角」——有的头想关注句法、有的头想关注语义,现在它们只能用同一套钥匙开所有的门。MQA 论文自己报告在翻译等任务上掉点,后续 GQA 论文的系统对比也确认:MQA 相对 MHA 有可测量的质量损失,而且从头训练 MQA 模型并不容易训到 MHA 的水平。
但 MQA 证明了最重要的一件事:KV 头数量和 Q 头数量根本不需要相等,注意力对 KV 头的冗余度极高。它只是砍得太狠——从 32 直接砍到 1,省过头了。
GQA:按组共享 KV
GQA(Ainslie et al., 2023)的回答是把「砍到 1」改成「砍到中间」:把 Q 头分组,每组共享一份 KV。32 个 Q 头分 8 组,每组 4 个 Q 头读同一份 K/V——
8 个 KV 头保有 8 种不同的 K/V 表征(对比 MQA 的 1 种),每个 Q 头在组内仍有同伴、跨组有差异。KV cache 缩到 1/4(512 → 128 KB/token),质量基本追平 MHA——GQA 论文的对比里,8 组 GQA 与 MHA 在翻译、摘要等基准上差距在噪声内,decode 速度却接近 MQA。
三个结构在这一个参数下统一了:
| 结构 | 关系 | |
|---|---|---|
| MHA | 每组 1 个 Q 头(不共享) | |
| GQA | 每组 个 Q 头 | |
| MQA | 全体 1 组(全共享) |
这就是名字里 Grouped 的含义——GQA 是那个泛化框架,MHA 和 MQA 是它两端的特例。
GQA 论文的第二个贡献是 uptraining(升格训练):不想从头重训怎么办?把训好的 MHA checkpoint 里同一组的 KV 头做 mean pooling 合并成一个头(组内平均,天然继承原有权重的信息),得到 GQA 初始化,再用原预训练量约 5% 的算力继续训。结果显示 mean-pooled 8 组 GQA + 5% uptraining ≈ 从头训练的 MHA——5% 的补救成本换 4 倍的推理缩减,这笔账所有人都会算。Llama2-70B 第一个大规模采用(64 Q 头 / 8 KV 头),此后 Llama3 全系(8B 就是 32/8,405B 是 128/8)、Mistral、Qwen 等清一色 GQA。主流收敛在 8 个 KV 头:再少了质量开始掉,再多了省得不够。
算一笔账:省下的 KV cache
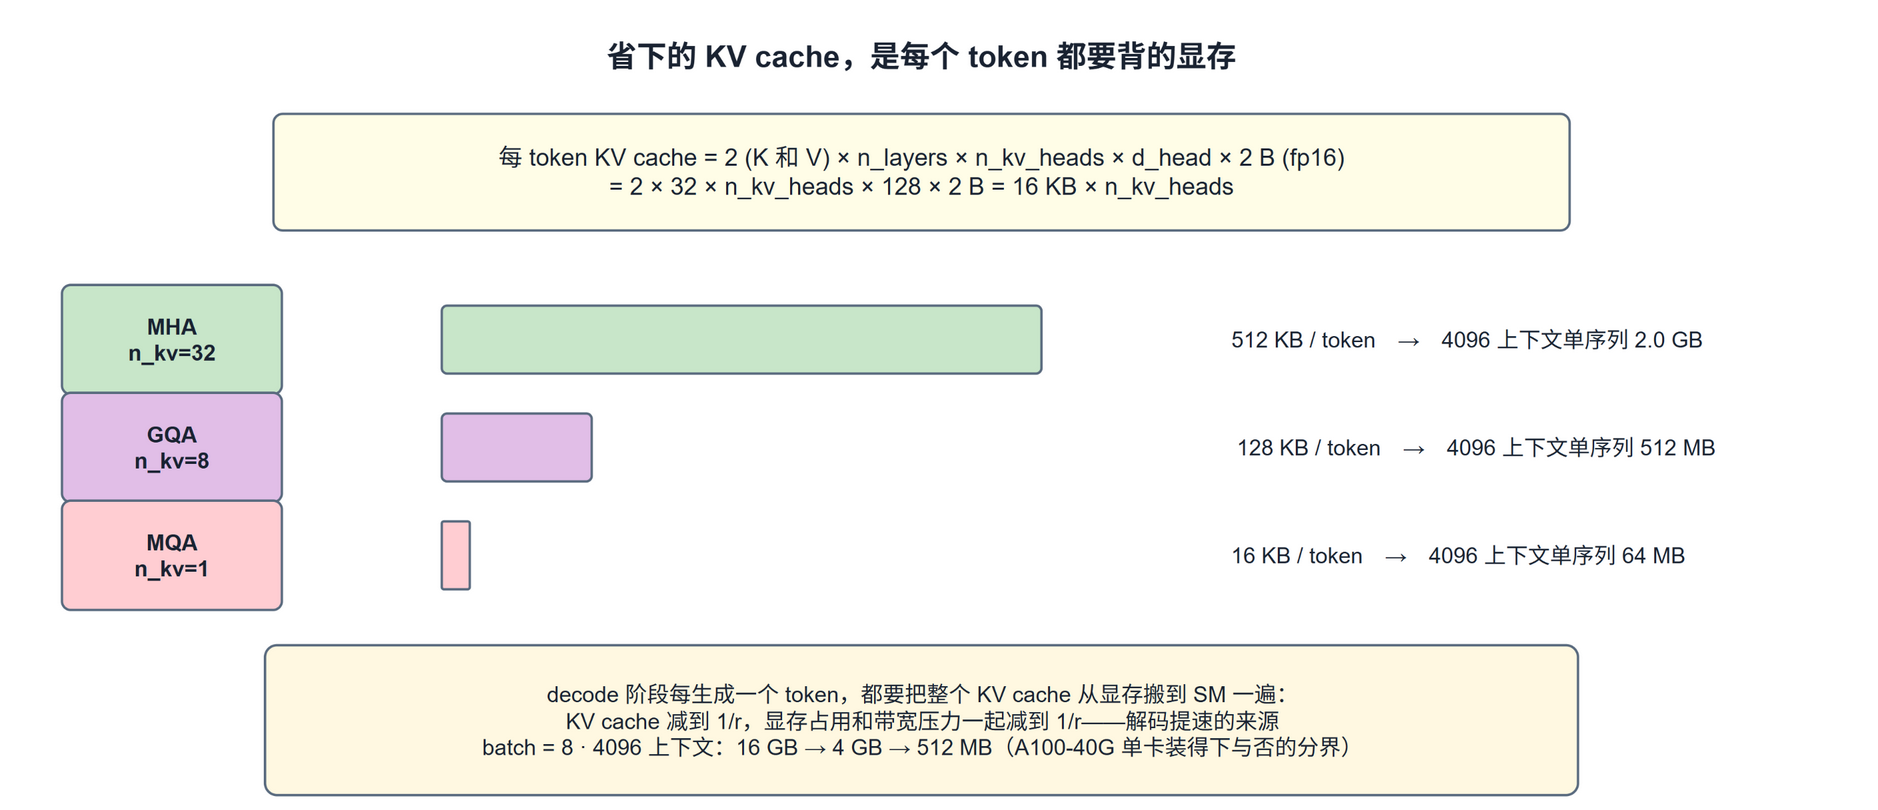
以 32 层、、fp16 为基准(Llama3-8B 规格),每 token KV cache :
| 每 token | 4096 ctx 单序列 | batch 8 | ||
|---|---|---|---|---|
| MHA | 32 | 512 KB | 2.0 GB | 16 GB |
| GQA | 8 | 128 KB | 512 MB | 4 GB |
| MQA | 1 | 16 KB | 64 MB | 512 MB |
两个视角:
- 显存视角决定 batch 上限。同一张 A100-40G:MHA 装两条 4096 序列就接近极限,GQA 能装八条——吞吐近似线性上涨,推理单价直接除以 4。
- 带宽视角决定单步延迟。decode 每步都要把整个 cache 从 HBM 读到计算单元,K、V 头缩到 1/4,每步搬运量就缩到 1/4。decode 本来就是带宽瓶颈(算一个 token 用全部历史),这一刀正中要害。
顺带的参数节省: 各从 16.8M 缩到 4.2M,每层省 25M,32 层合计约 1.5 GB(fp16)——相对 cache 的节省是小头,但方向相同。
代码实现:算之前把 KV 头补回来
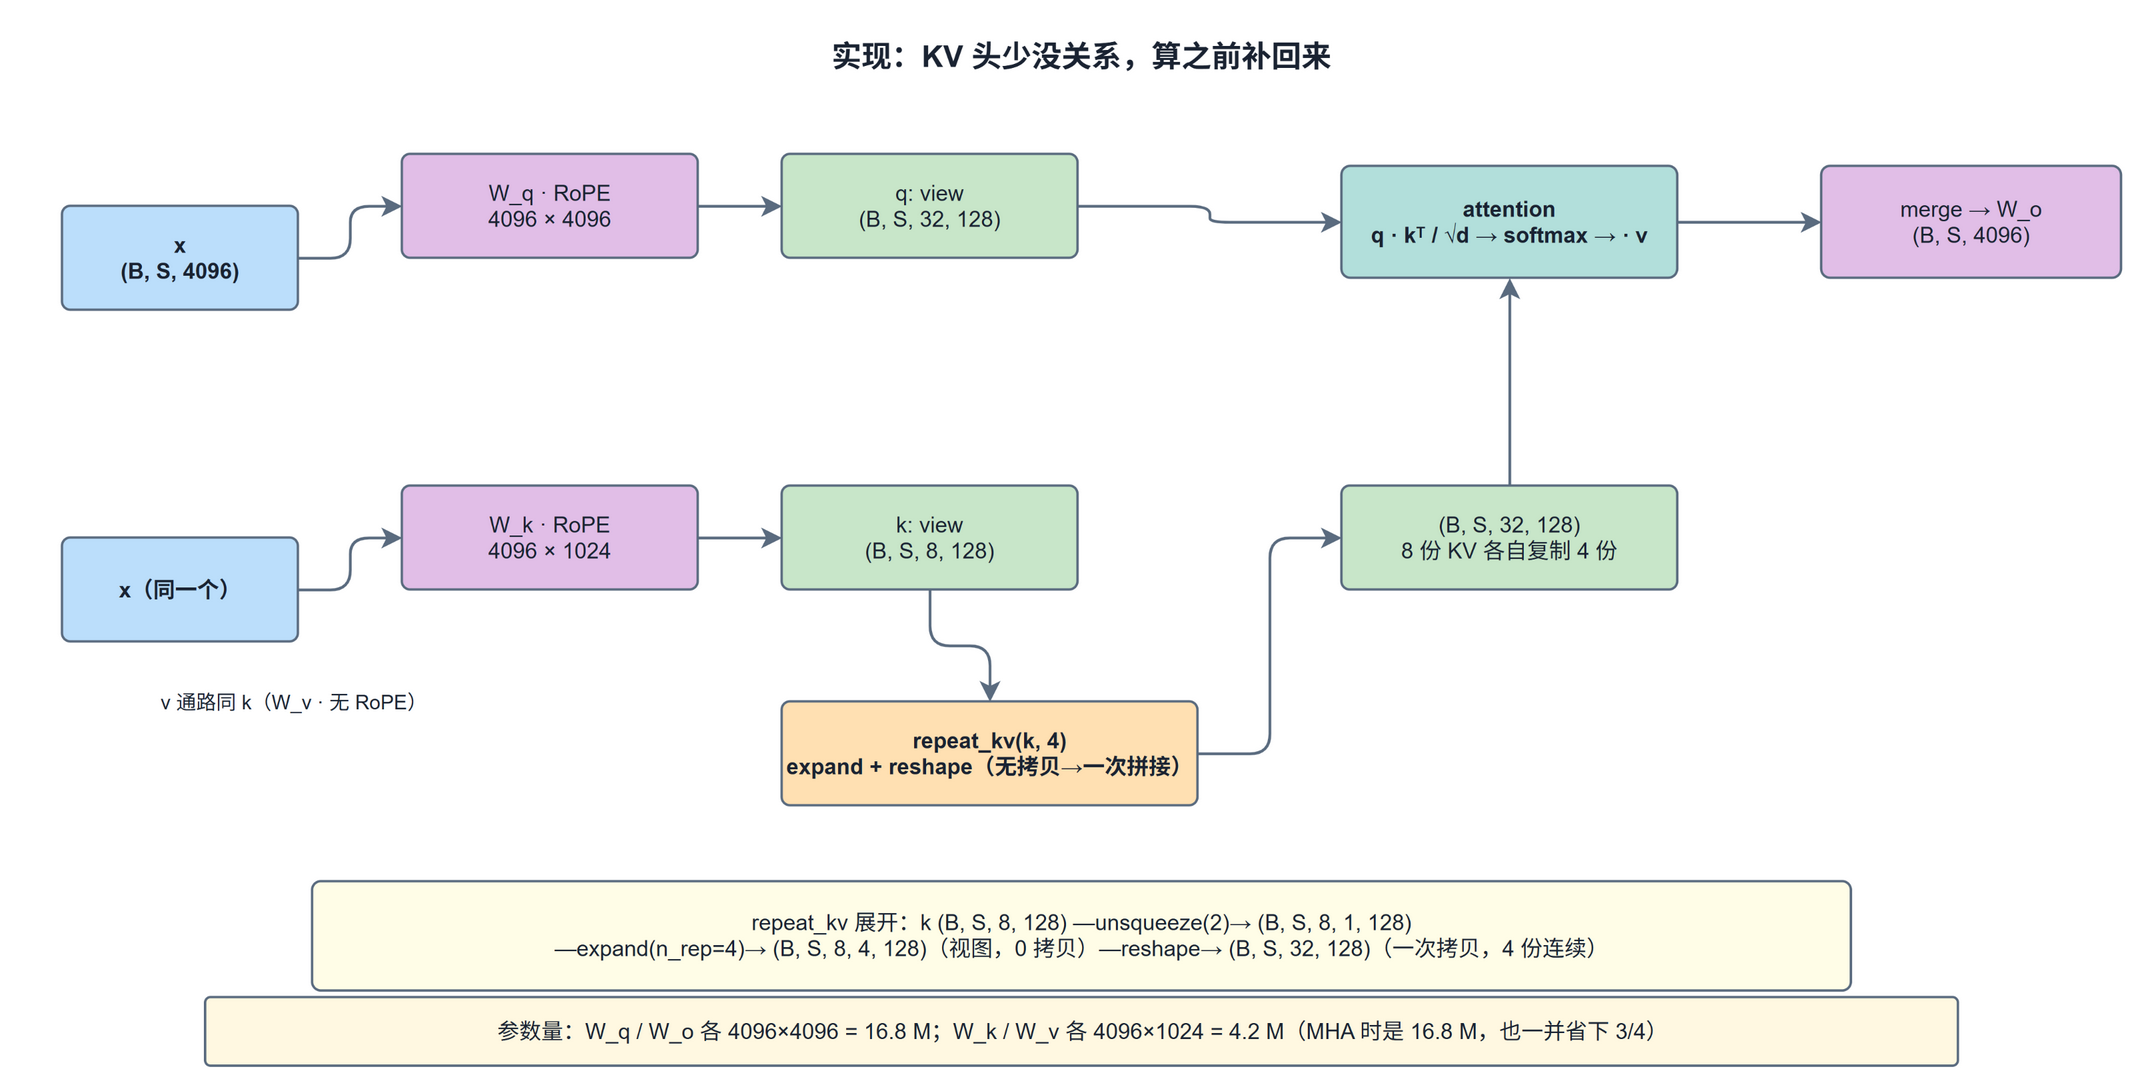
实现出乎意料地直白,因为有一个观察:GQA 数学上就是一个权重共享的 MHA。组内 4 个 Q 头读同一份 K/V,等价于把这份 K/V 复制 4 份、按普通 MHA 算。所以训练和简单推理的实现是「窄投影 + 算前补头」两步(llama 风格):
class Attention(nn.Module):
    def __init__(self, dim=4096, n_q=32, n_kv=8, d_h=128):
        super().__init__()
        self.n_rep = n_q // n_kv                          # 4
        self.wq = nn.Linear(dim, n_q * d_h, bias=False)   # 4096 × 4096
        self.wk = nn.Linear(dim, n_kv * d_h, bias=False)  # 4096 × 1024 ← 窄在这里
        self.wv = nn.Linear(dim, n_kv * d_h, bias=False)  # 4096 × 1024
        self.wo = nn.Linear(n_q * d_h, dim, bias=False)

    def forward(self, x, rope):                           # x: (B, S, 4096)
        B, S, _ = x.shape
        q = self.wq(x).view(B, S, 32, 128)                # Q 全量 32 头
        k = self.wk(x).view(B, S, 8, 128)                 # K 只有 8 头
        v = self.wv(x).view(B, S, 8, 128)
        q, k = apply_rope(q, k)                           # RoPE 只碰 Q、K
        k, v = repeat_kv(k, self.n_rep), repeat_kv(v, self.n_rep)
        out = scaled_dot_product_attention(q, k, v)       # 当普通 MHA 算
        return self.wo(out)
与 MHA 实现的 diff 只有两行:投影宽度( 而非 )和 repeat_kv。核心就这一个函数:
def repeat_kv(h, n_rep):              # h: (B, S, 8, 128)
    B, S, H_kv, D = h.shape
    x = h[:, :, :, None, :]           # (B, S, 8, 1, 128)  插一根组维度
    x = x.expand(B, S, H_kv, n_rep, D)# (B, S, 8, 4, 128)  视图,0 拷贝
return x.reshape(B, S, H_kv * n_rep, D) # (B, S, 32, 128) 一次拷贝三步各有分工:unsqueeze 给每个 KV 头插一根组维度;expand 沿组维广播——只改 stride 不碰数据,零拷贝;reshape 把组维摊平进头维,因为摊平后不再连续,才发生一次实际拷贝。全流程 K、V 各拷一次,无多余搬运。
用最小例子手算(2 个 KV 头、各复制 2 份,;经 PyTorch 实测):
k: (1, 1, 2, 4)   头0 = [1,0,0,0]   头1 = [0,1,0,0]
repeat_kv(k, 2) →
  头0 → 槽位 0, 1:  [1,0,0,0]  [1,0,0,0]
  头1 → 槽位 2, 3:  [0,1,0,0]  [0,1,0,0]
即 Q 头 0、1 读槽位 0(KV 头 0 的内容),Q 头 2、3 读槽位 1——KV 头 的内容占据槽位 ,组内的 Q 头们共享同一段。分组映射是「槽位整除」:Q 头 归属 KV 头 ,也就是图 1 里相邻 4 个 Q 头框成一组的那种连法。
最后一个工程细节:repeat_kv 这种「物化补头」是正确性优先的写法,训练和参考实现都用它。生产推理引擎不这么做——FlashAttention-2 原生接受 的输入(组内共享直接在 kernel 里索引,不做复制),vLLM 的 PagedAttention 同理按组映射物理块。省下的搬运不去补,才是 GQA 在推理端的完全体;cache 里永远只存 8 份,repeat 只发生在需要喂给「不认识 GQA」的算子时。
总结
- 三种结构只差一个参数 :MHA ,MQA ,GQA 居中;GQA 是泛化框架,另两个是特例;
- 动机全在推理:decode 每步读整个 KV cache,显存定 batch 上限、带宽定单步延迟,两头都被 线性放大;
- MQA 证明了 KV 头高度冗余,但砍到 1 掉质量;GQA 8 组基本追平 MHA,主流模型收敛在 8 个 KV 头;
- uptraining:MHA 权重组内 mean pooling + 5% 预训练算力,旧 checkpoint 5% 成本升级;
- 实现 = MHA 减两行: 投影变窄,
repeat_kv算前补头(expand 视图 + reshape 一次拷贝);生产 kernel 原生分组,不物化。
延伸
两条顺藤摸瓜的线:一是 DeepSeek-V2 的 MLA——不共享 KV 头,而是把 K/V 压到低秩隐空间再按需投影,KV cache 压到比 GQA 更小,代价是注意力结构变复杂、部分生态兼容成本高,可以对照「共享」与「压缩」两条路线的取舍;二是 KV cache 量化(KV int8/int4)——和 GQA 正交,都在治同一个病,工程上常叠加使用。想动手的话:把上文 Attention 类接进你的 mini-Llama,跑通后再把 repeat_kv 换成 F.scaled_dot_product_attention(q, k, v, enable_gqa=True),用 profiler 对比两种写法的显存与耗时差异。