先说结论:RoPE 的全部数学只有四个公式——
| 公式 | 一句话 |
|---|
| ① 频率 | ωi=base−2i/d | 每对维度一根指针,转速写死 |
| ② 角度 | θm,i=mωi | 位置 × 转速 = 角度,位置编码到此完成 |
| ③ 旋转 | x1′=x1cosθ−x2sinθ,x2′=x1sinθ+x2cosθ | 按角度旋转一对维度 |
| ④ 性质 | R(m)⊤R(n)=R(n−m) | 两个绝对旋转相乘 = 一个相对旋转,一切成立的原因 |
需要的背景只有一件事:注意力打分是内积 qA⋅kB,只看两个向量的内容,天生不知道词的先后顺序,所以要把位置注入进去。而且该注入的是「隔多远」,不是「在第几位」——同一对词挪到文中任何地方,打分不该变。把位置加到向量里做不到这一点(内积一展开就留下绝对位置项,消不掉);RoPE 把位置做成角度,靠公式④让绝对位置在内积里自动消失。
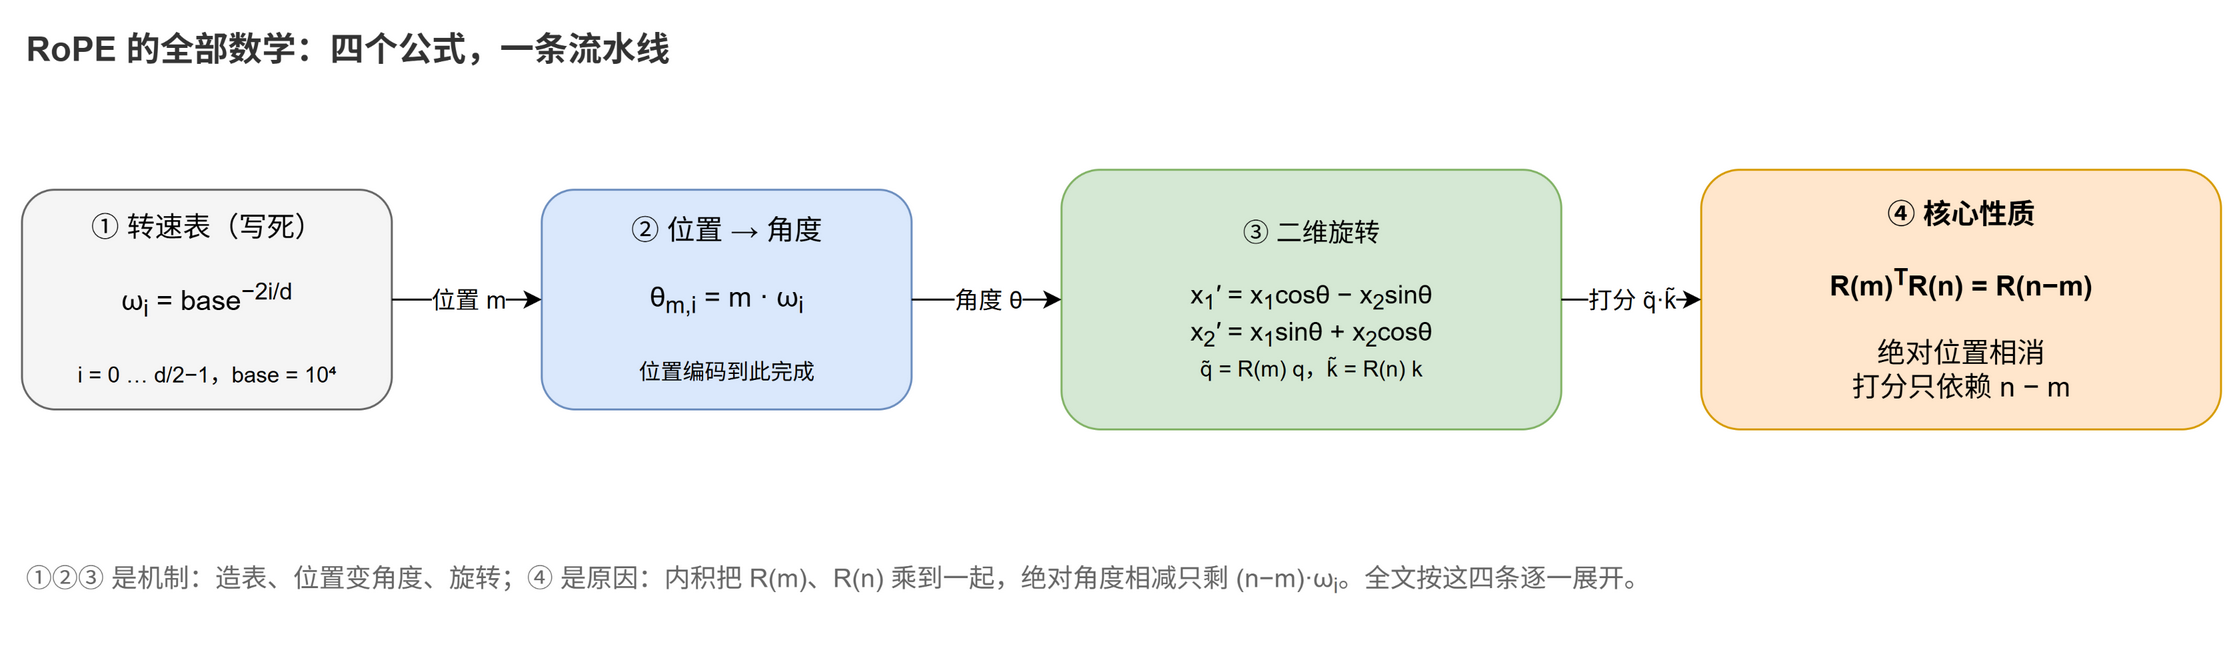
①②③ 是机制:造表、位置变角度、旋转。④ 是原因。下面逐条讲清楚,然后单独讲代码实现,最后用一组能手算的数字把四条全部走通。
① 频率:每对维度一根指针
把 d 维向量切成 d/2 对,第 i 对分到一个固定转速:
ωi=base−2i/d,i=0,1,…,2d−1 base = 10000(Llama3 提到 5×10⁵)。d=128 时:ω0=1 最快,ω63≈1.2×10⁻⁴ 最慢,对应的转圈周期(波长 2π/ωi)从约 6 个词到约 5.4 万个词。
为什么要 64 根不同的指针?一根不够:cos((n−m)ω) 有周期,相差整圈的距离读数完全相同,分不开。快针(ω 大)分辨近处,慢针(ω 小)覆盖远处——像秒针、分针、时针各管一段,组合读数才能定位。这张表没有任何可学习参数,是写死的常数。
② 角度:位置 × 转速
θm,i=mωi 位置 m 的词,第 i 对维度要转的角度。类比:秒针每秒 6°,走了 m 秒就转 m×6°。
「位置编码」这一步就完成了——位置变成了角度,没有任何参数要学。注意角度逐对不同:同一个 m,在 64 对维度上转出 64 个不同的角度,这就是①的转速表在起作用。
③ 旋转:角度作用到一对维度
拿到角度,怎么转?旋转是二维运算——角度天然定义在一张平面上,所以 RoPE 不是把整根向量转一个角度,而是两两一组:d 维切成 d/2 组,每组 2 个维度构成一张平面,在自己的平面上独立转。对 (x1,x2) 这一组,转 θ 就是:
R(θ)=(cosθsinθ−sinθcosθ),x1′x2′=x1cosθ−x2sinθ=x1sinθ+x2cosθ 具体到 d=8(按论文的相邻配对,vj 是第 j 维):
| 组 | 两个维度 | 各自的转角 |
|---|
| 1 | (v0, v1) | θm,1=mω1 |
| 2 | (v2, v3) | θm,2=mω2 |
| 3 | (v4, v5) | θm,3=mω3 |
| 4 | (v6, v7) | θm,4=mω4 |
(d=128 就是 64 组,每组用自己的 ωi。)这个「两两一组」有两条关键性质:
- 组内混合:v0′ 同时由 v0 和 v1 决定(cos、sin 交叉相乘)——旋转就发生在这两个维度撑起的平面上;
- 组间独立:v0′ 只依赖第 1 组,和 v2…v7 无关——所以整根向量的变换矩阵是分块对角的,R(m)=diag(R(θm,1), …, R(θm,d/2)):64 个 2×2 小块沿对角线排开,互不干扰。
位置 m 的 Q、K 变成 q~=R(m)q、k~=R(n)k。旋转只改变方向、不改变长度(∥Rq∥=∥q∥),内容的大小关系全部保留。(哪两个维度凑成一组有两种约定,数学等价,见代码节。)
机制到此讲完:①造表、②变角、③旋转。但为什么这么转,打分就自动只依赖相对距离?靠④。
④ 核心性质:R(m)⊤R(n)=R(n−m)
理解 RoPE 最重要的一条公式。先看它从哪来。注意力打分是内积,把③的结果代进去:
q~⋅k~=(R(m)q)⊤(R(n)k)=q⊤两个绝对旋转相乘R(m)⊤R(n)k 内积自动把位置 m 的旋转和位置 n 的旋转乘到了一起。这个乘积是什么?两条初等性质,各一行就能验证:
- 转置 = 反转:R(θ)⊤=R(−θ)。从③的矩阵看,转置恰好把 −sin 换了边,等于反着转;
- 复合 = 相加:R(a)R(b)=R(a+b)。用③的矩阵直接乘开,就是和角公式 cos(a+b)=cosacosb−sinasinb。
两条性质合起来,④就出来了:
R(m)⊤R(n)=R(−θm,i)R(θn,i)=R(θn,i−θm,i)=R((n−m)ωi)=R(n−m) (第三步用的是②:θn,i−θm,i=(n−m)ωi。记号 R(n−m) 是转 (n−m)ωi 的简写;每对维度上都成立,整根向量的分块矩阵同样成立。)
代回打分:
q~⋅k~=q⊤R(n−m)k m 和 n 单独消失了,只剩 n−m。这就是「相对位置编码」四个字的确切含义:词对 (3,5) 和 (1003,1005) 的打分完全一样,因为距离都是 2。
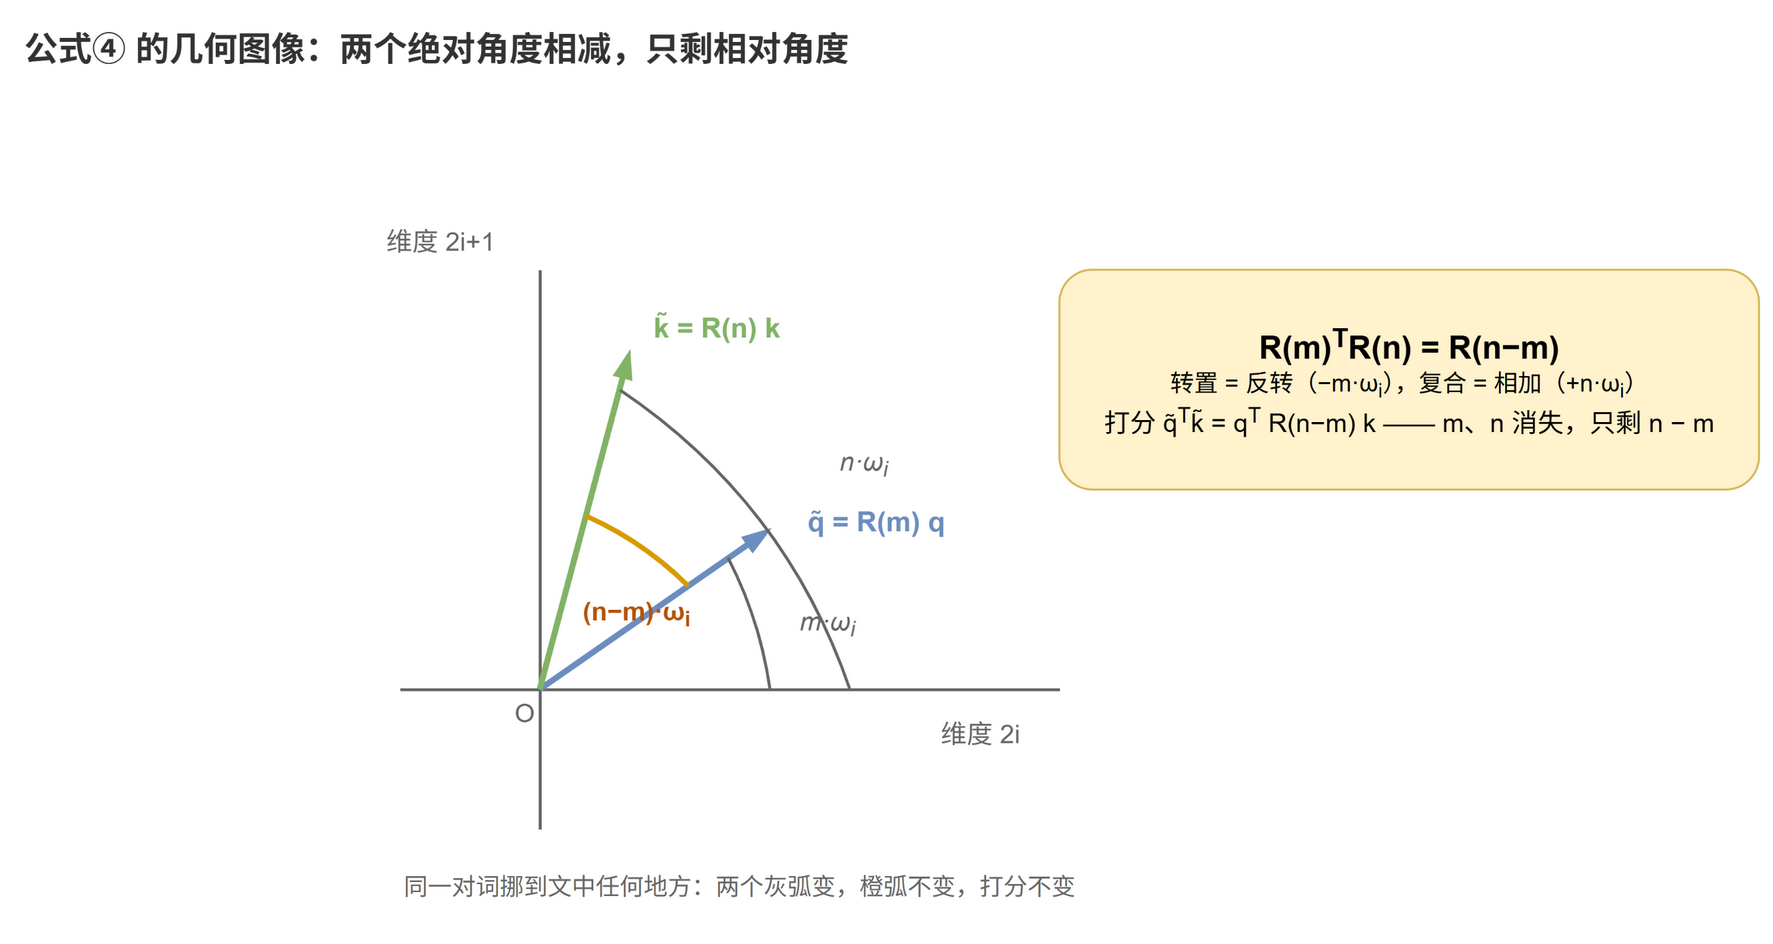
几何上就是角度相减:q~ 转过 mωi,k~ 转过 nωi,两个灰弧是各自的绝对角度,橙弧是夹角 (n−m)ωi。同一对词往后挪 100 个位置:两个灰弧都变,橙弧不变——打分只看橙弧。
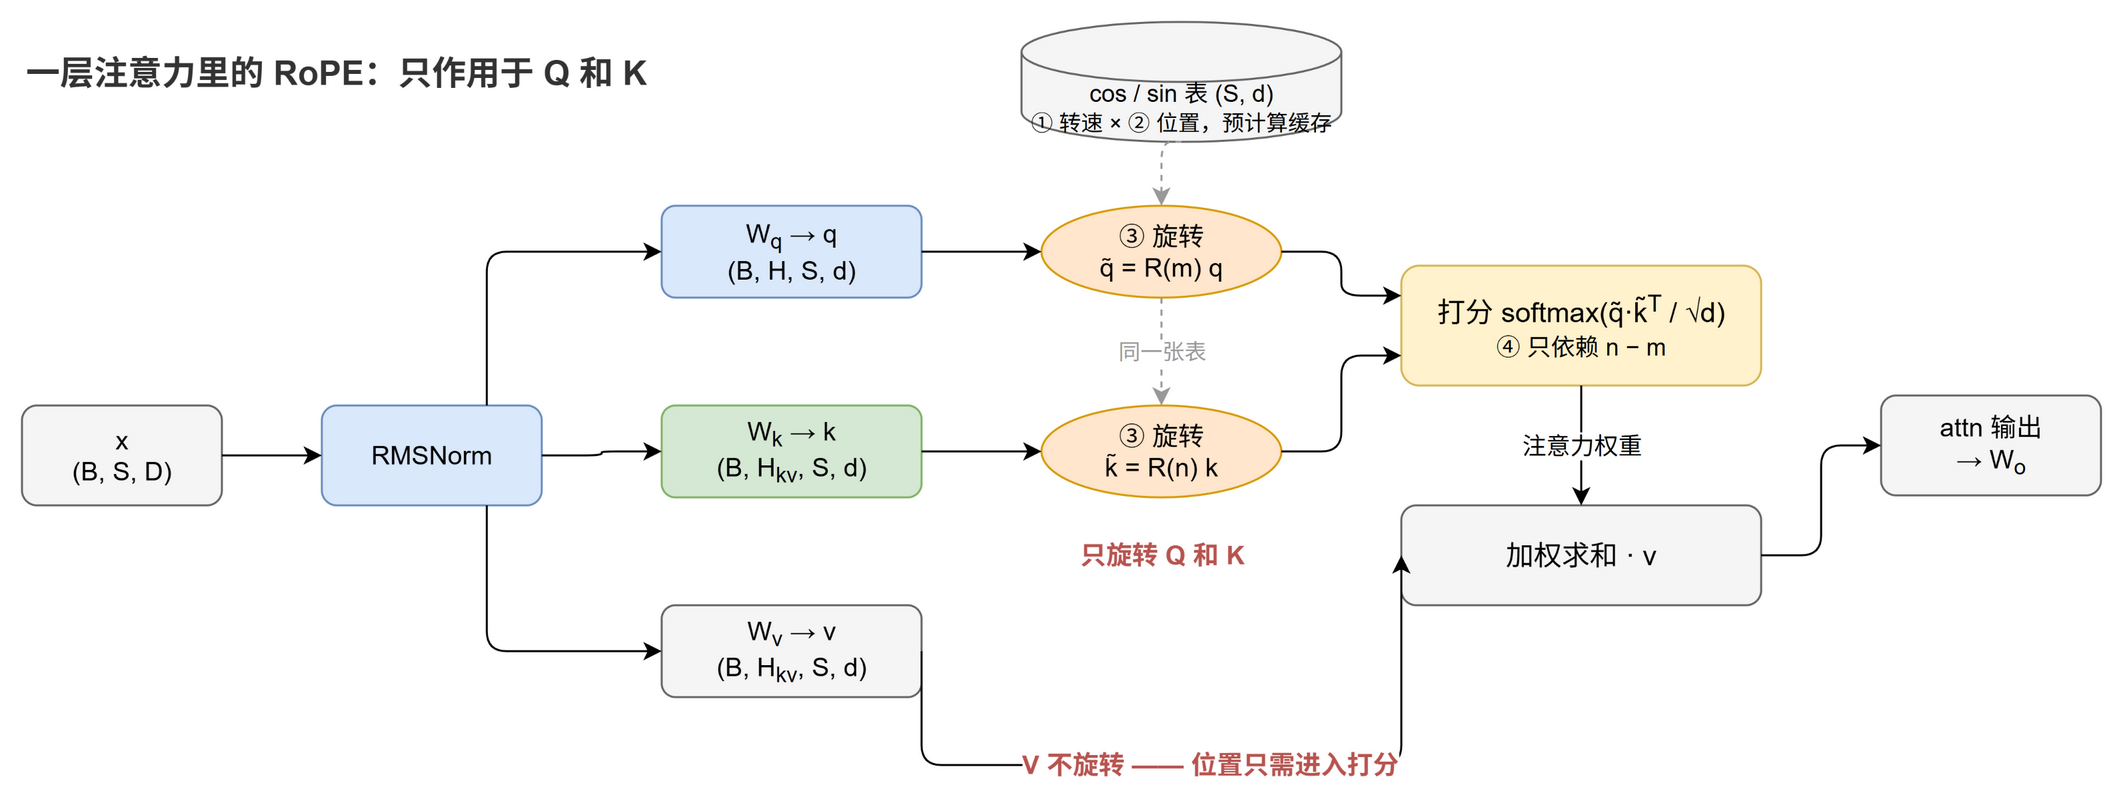
④也是所有工程优势的来源:注意力公式一字未改,只是 Q、K 进场前先转个角度,所以 KV cache、FlashAttention 原样可用;V 不用转——位置信息的唯一用途是参与打分,V 是被打分加权的内容本身。
(原论文用复数记号推导④:把一对维度看成复数,旋转 = 乘 eiθ,共轭相乘时角度相消。本质相同,矩阵记号更直白。)
代码实现:四个公式在代码里的位置
原理到此结束,实现单独看(llama2/model.py)。对照①②③④读,每一行都能认领:
def precompute_rope_cache(seq_len, head_dim, base=10000.0):
    inv_freq = 1.0 / (base ** (torch.arange(0, head_dim, 2).float() / head_dim))  # ① ωᵢ
    t = torch.arange(seq_len).float()                                            # 位置 m
    freqs = torch.outer(t, inv_freq)          # ② θ_{m,i} = m·ωᵢ,(S, d/2)
    emb = torch.cat((freqs, freqs), dim=-1)   # 复制成 (S, d):前半/后半同用一套角
    return emb.cos(), emb.sin()               # ③ 的原料
旋转角只依赖 (m,i),和内容无关,训练前算一次缓存成 buffer。
③ 的高效实现是全文最巧的一步。R(m) 是 d×d 的稀疏矩阵,直接矩阵乘又大又慢;观察到它分块对角、每块只有 cos 和 sin,乘法可以重排成逐元素乘加。设配对为前半 x、后半 y(第 i 维和第 i+d/2 维一对,原因见下面配对约定),③变成:
v~=(xcos−ysin; ycos+xsin)=vcos+(−y;x)sin 而 (−y;x) 正是 rotate_half 做的事:
def rotate_half(x):                    # [x1, x2] → [-x2, x1]
    x1, x2 = x.chunk(2, dim=-1)
    return torch.cat((-x2, x1), dim=-1)

def apply_rope(q, k, cos, sin):
    cos = cos.unsqueeze(0).unsqueeze(0)     # (S,d)→(1,1,S,d):batch、head 维广播
    sin = sin.unsqueeze(0).unsqueeze(0)
    q_rot = (q * cos) + (rotate_half(q) * sin)
    k_rot = (k * cos) + (rotate_half(k) * sin)
    return q_rot, k_rot                     # ④ 的效果在这里兑现;只碰 Q、K
旋转就是一行 v * cos + rotate_half(v) * sin:「配对维度交叉」的矩阵结构被压缩成一次 chunk + cat。cos/sin 表复制成两份的原因也在这:前半的 xi 和后半的 yi 用同一个 ωi。
两个必须知道的工程细节:
- 配对约定有两种,等价但权重不互通。论文是相邻配对 (2i, 2i+1);这份实现(HuggingFace Llama / NeoX 风格)是前半配后半 (i, i+d/2)。只差一个维度排列,forward 数学上等价;但预训练权重里的维度排列跟着训练时的约定走,加载第三方权重时配错,模型会静默输出乱码——手写实现最典型的「跑通但不对」。
- 只旋转 Q、K,V 直通(图里 V 那条路绕过旋转节点)。
案例:d = 4,四个公式手算一遍
用 d=4(两对维度)、手选好算的转速,把①②③④用一组数字全部走通:
① 转速:ω=(30°, 15°)。
② 角度:q 放位置 m=2,角度 (2×30°, 2×15°)=(60°, 30°);k 放位置 n=5,角度 (150°, 75°)。
设 q=(1,1,0,0)、k=(0,0,1,1)。按代码用的前/后半配对(第 i 维和第 i+d/2 维一组,d=4 时就是 (0,2)、(1,3) 两组):平面 1 = (q0,q2)=(1,0),平面 2 = (q1,q3)=(1,0);k 的两个平面都是 (0,1)。
③ 旋转。 q 的平面 1 转 60°:(1,0)→(0.5, 0.866);平面 2 转 30°:(1,0)→(0.866, 0.5)。结果写回各自的维度(平面 1 → 维度 0 和 2,平面 2 → 维度 1 和 3):
q~=(0.5, 0.866, 0.866, 0.5) k 的平面 1 转 150°:(0,1) 从 90° 转到 240°,(−0.5, −0.866);平面 2 转 75°:转到 165°,(−0.966, 0.259):
k~=(−0.5, −0.966, −0.866, 0.259) ④ 打分。
q~⋅k~=−0.25−0.837−0.75+0.13=−1.707 逐平面看更清楚:平面 1 夹角 240°−60°=180°,贡献 cos180°=−1;平面 2 夹角 165°−30°=135°,贡献 cos135°=−0.707。−1−0.707=−1.707 ✓——打分是各平面读数之和,每个平面里绝对角度都已相减(④)。
④ 的两个直接验证:
- 平移不变:整对词后挪 10 位(m=12, n=15,距离仍 3)→ q~′=(1,−1,0,0),k~′=(−1, 0.707, 0, −0.707),内积 −1−0.707=−1.707,不变;
- 距离敏感:k 挪到 n=4(距离 2)→ 两平面夹角 150° 和 120°,打分 −0.866−0.5=−1.366=−1.707,变了。
同一组数字过代码。 m=2 那行表:cos=(0.5, 0.866, 0.5, 0.866),sin=(0.866, 0.5, 0.866, 0.5);rotate_half(1, 1, 0, 0) = (0, 0, 1, 1):
q * cos              = (0.5,   0.866, 0,     0   )
rotate_half(q) * sin = (0,     0,    0.866, 0.5 )   ← 相加
                     = (0.5,   0.866, 0.866, 0.5)   ← 手算的 q̃,一致
可运行版(输出经 PyTorch 实测):
import torch
omega = torch.tensor([30, 15]) * torch.pi / 180    # ① ω = (30°, 15°)

def rot(x, m):                                     # ② + ③
    ang = m * omega
    c = torch.cat([ang.cos(), ang.cos()]); s = torch.cat([ang.sin(), ang.sin()])
    return x * c + rotate_half(x) * s

q = torch.tensor([1., 1., 0., 0.]); k = torch.tensor([0., 0., 1., 1.])
print(rot(q, 2))                # [0.5000, 0.8660, 0.8660, 0.5000] — ③ 的 q̃
print(rot(q, 2) @ rot(k, 5))    # -1.7071 — ④ 打分(距离 3)
print(rot(q, 12) @ rot(k, 15))  # -1.7071 — 平移 +10,不变
print(rot(q, 2) @ rot(k, 4))    # -1.3660 — 距离 2,变了
总结
- ① ωi=base−2i/d:64 根快慢指针,写死的常数表,快针管近处、慢针管远处;
- ② θm,i=mωi:位置乘转速——位置编码的全部,零参数;
- ③ 二维旋转:逐对维度转 θm,i,只改方向不改长度,R(m) 分块对角;
- ④ R(m)⊤R(n)=R(n−m):转置 = 反转、复合 = 相加,内积把两个绝对旋转乘到一起,绝对位置消掉,打分 =q⊤R(n−m)k,只剩相对距离;
- 实现:
precompute_rope_cache 是①②,rotate_half + 逐元素乘加是③,只旋转 Q、K;配对约定等价但权重不互通。
延伸
④保证了「训练长度内,打分只依赖距离」,但没解决「训练 4K、推理 128K」:超出训练见过的距离后,慢针也开始转满圈,不同距离的读数撞车(混叠)。沿这条线长出一族长度外推方法——位置插值(PI)把位置线性压回训练范围,NTK-aware 调大 base 让慢针更慢,YaRN 是两者的组合;Llama3 则直接把 base 提到 5×10⁵ 用长数据重训。想继续动手:把案例里的 rot 扩到 d=128,画出各平面的 cos(mωi) 曲线,秒针、分针、时针会直接长在眼前。